TP Python 4 : Opérations Raster
Exécution dans le cloud : ce notebook peut aussi tourner dans le cloud (Colab, Kaggle, Renku). Avant de lancer les cellules, télécharge les rasters (dossiers
rasters/etdhm25_p/) depuis le dossier OneDrive du cours et dépose-le dans le répertoire de travail du notebook (Colab : panneau 📁 → Upload ; Kaggle : File → Upload ; Renku : déjà dans le projet). Procédure complète : docs/cloud -badges .md.
TP Python 4 : Opérations Raster¶
Ce TP Python est le pendant numérique du TP QGIS 4. Tu vas reproduire les mêmes opérations raster en Python avec rasterio et numpy.
| Info QGIS | Attribut rasterio |
|---|---|
| Système de référence | src.crs |
| Dimensions | src.height, src.width |
| Emprise | src.bounds |
| Résolution pixel | src.res |
| Nombre de bandes | src.count |
| Valeur NoData | src.nodata |
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.colors as mcolors
from matplotlib.patches import Patch

import rasterio
from rasterio.plot import show
from rasterio.transform import from_bounds
from rasterio.warp import reproject, Resampling

from scipy.interpolate import griddata

import geopandas as gpd
import os# Adapte les chemins selon l'emplacement de tes fichiers
BAND_FILES = [
'rasters/Landsat4_1990_194028_b1.tif',
'rasters/Landsat4_1990_194028_b2.tif',
'rasters/Landsat4_1990_194028_b3.tif',
'rasters/Landsat4_1990_194028_b4.tif',
'rasters/Landsat4_1990_194028_b5.tif',
'rasters/Landsat4_1990_194028_b6.tif',
'rasters/Landsat4_1990_194028_b7.tif',
]
LANDCOVER_FILE = 'rasters/MapTicino1990_8classes.tif'
MNT_FILE = 'rasters/MNT25_Ticino.tif'
DHM25_PATH = 'dhm25_p/dhm25_p.shp' # semis de points altimétriques (Partie 6)
# Lecture des métadonnées de la bande 4 (proche infrarouge)
with rasterio.open(BAND_FILES[3]) as src: # index 3 = bande 4
print("=== Métadonnées — Bande 4 (NIR) ===")
print(f"CRS : {src.crs}")
print(f"Dimensions : {src.height} lignes × {src.width} colonnes")
print(f"Résolution : {src.res[0]:.1f} m × {src.res[1]:.1f} m")
print(f"Emprise : {src.bounds}")
print(f"Type données : {src.dtypes[0]}")
print(f"NoData : {src.nodata}")
meta_ref = src.meta.copy() # métadonnées de référence pour les sorties
=== Métadonnées — Bande 4 (NIR) ===
CRS          : EPSG:32632
Dimensions   : 7292 lignes × 8212 colonnes
Résolution   : 31.1 m × 31.3 m
Emprise      : BoundingBox(left=366798.8360244284, bottom=4983476.32585051, right=621856.6517301749, top=5212035.991148069)
Type données : uint8
NoData       : None
1.2 Fusion des bandes séparées en image multibandes¶
Dans QGIS tu utilisais Raster > Miscellaneous > Merge avec l’option
“Place each input file in a separate band”.
En Python : on empile les tableaux NumPy des 7 bandes avec np.stack()
et on écrit le résultat dans un GeoTIFF à 7 bandes.
# Lecture des 7 bandes et empilement
bands = []
for path in BAND_FILES:
    with rasterio.open(path) as src:
        bands.append(src.read(1).astype(np.float32))

landsat = np.stack(bands)   # shape : (7, height, width)
print(f"Image multibandes : {landsat.shape}")
print(f"  7 bandes × {landsat.shape[1]} lignes × {landsat.shape[2]} colonnes")

# Sauvegarde GeoTIFF multibandes (équivalent du Merge QGIS)
os.makedirs('rasters/output', exist_ok=True)
meta_multi = meta_ref.copy()
meta_multi.update({'count': 7, 'dtype': 'float32'})

with rasterio.open('rasters/output/Landsat4_1990_multibande.tif', 'w', **meta_multi) as dst:
    dst.write(landsat)

print("\nGeoTIFF multibandes sauvegardé : rasters/output/Landsat4_1990_multibande.tif")
Image multibandes : (7, 7292, 8212)
  7 bandes × 7292 lignes × 8212 colonnes
GeoTIFF multibandes sauvegardé : rasters/output/Landsat4_1990_multibande.tif
Partie 2 — Compositions colorées¶
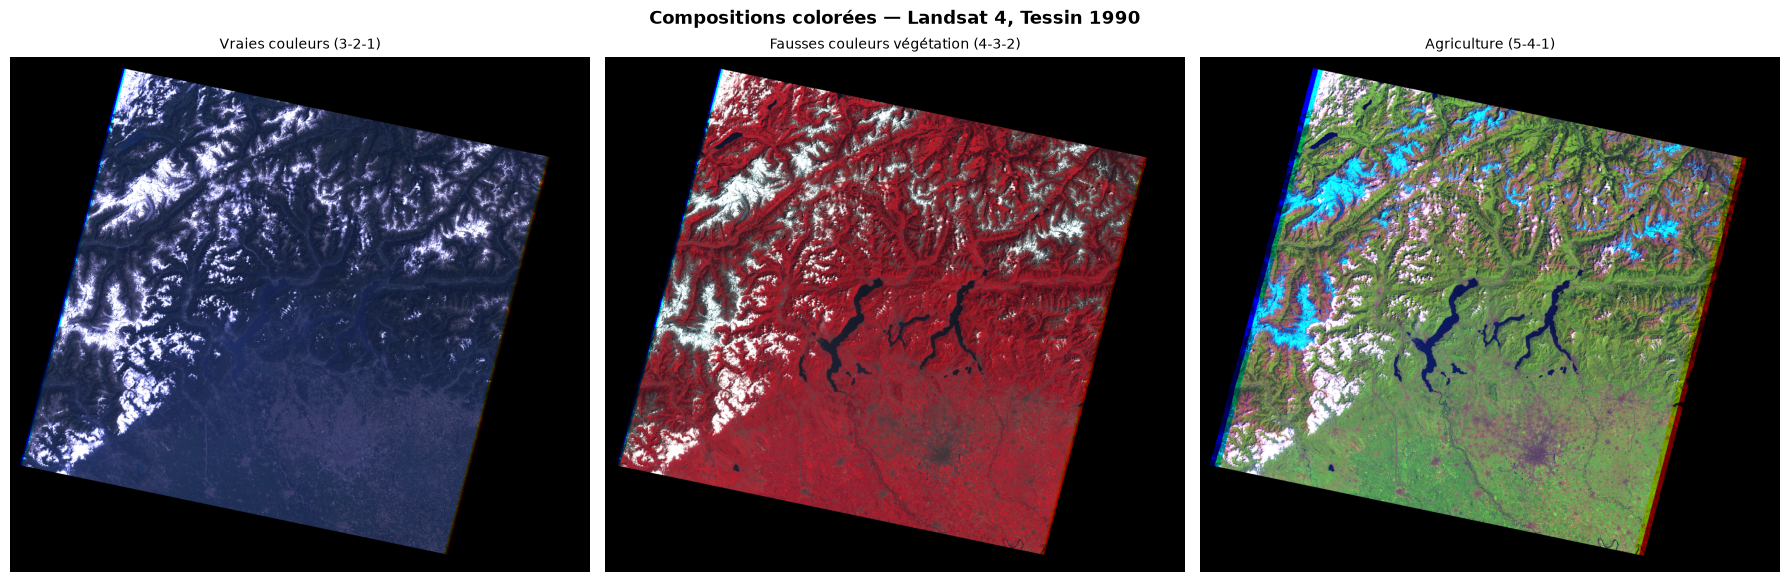
Dans QGIS tu choisissais les bandes R/G/B dans la symbologie. En Python : on sélectionne les indices des bandes, on les normalise et on les empile.
| Composition | Bande R | Bande G | Bande B | Usage |
|---|---|---|---|---|
| Vraies couleurs | B3 | B2 | B1 | Vision naturelle |
| Fausses couleurs (végétation) | B4 | B3 | B2 | Végétation en rouge vif |
| Agriculture | B5 | B4 | B1 | Cultures, humidité |
def normalize_band(arr, pmin=2, pmax=98):
    """Étirement de contraste : coupe les percentiles extrêmes et normalise en [0, 1]."""
    lo, hi = np.nanpercentile(arr, [pmin, pmax])
    return np.clip((arr - lo) / (hi - lo + 1e-6), 0, 1)

def make_rgb(r_idx, g_idx, b_idx):
    """Construit une image RGB normalisée depuis les indices de bandes (1-based)."""
    r = normalize_band(landsat[r_idx - 1])
    g = normalize_band(landsat[g_idx - 1])
    b = normalize_band(landsat[b_idx - 1])
    return np.dstack([r, g, b])

compositions = [
    ('Vraies couleurs (3-2-1)',             3, 2, 1),
    ('Fausses couleurs végétation (4-3-2)', 4, 3, 2),
    ('Agriculture (5-4-1)',                 5, 4, 1),
]

fig, axes = plt.subplots(1, 3, figsize=(18, 6))
for ax, (title, r, g, b) in zip(axes, compositions):
    ax.imshow(make_rgb(r, g, b), origin='upper')
    ax.set_title(title, fontsize=10)
    ax.axis('off')

plt.suptitle('Compositions colorées — Landsat 4, Tessin 1990',
             fontsize=13, fontweight='bold')
plt.tight_layout()
plt.show()
Partie 3 — Calcul du NDVI¶
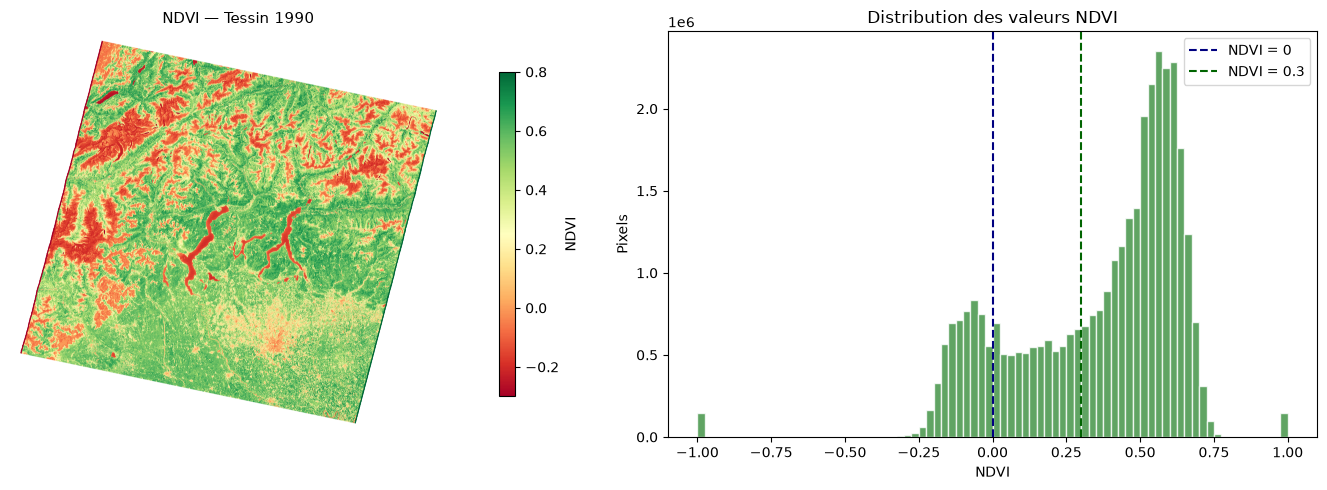
Le NDVI est calculé depuis la Calculatrice raster dans QGIS. En Python : opération pixel-à-pixel NumPy sur les bandes B3 et B4.
| Plage NDVI | Interprétation |
|---|---|
| -1 à 0 | Eau, neige, surfaces imperméables |
| 0 à 0.3 | Sol nu, rochers |
| 0.3 à 1 | Végétation dense (forêt, prairies) |
rouge = landsat[2].astype(np.float32)   # B3 = Rouge
nir   = landsat[3].astype(np.float32)   # B4 = NIR

with np.errstate(divide='ignore', invalid='ignore'):
    ndvi = np.where(
        (nir + rouge) == 0,
        np.nan,
        (nir - rouge) / (nir + rouge)
    )

print(f"NDVI — min={np.nanmin(ndvi):.3f}, max={np.nanmax(ndvi):.3f}, "
      f"moy={np.nanmean(ndvi):.3f}")

fig, axes = plt.subplots(1, 2, figsize=(14, 5))

im = axes[0].imshow(ndvi, cmap='RdYlGn', vmin=-0.3, vmax=0.8, origin='upper')
plt.colorbar(im, ax=axes[0], label='NDVI', shrink=0.8)
axes[0].set_title('NDVI — Tessin 1990', fontsize=11)
axes[0].axis('off')

axes[1].hist(ndvi[~np.isnan(ndvi)].ravel(), bins=80,
             color='#388e3c', alpha=0.8, edgecolor='white')
axes[1].axvline(0,   color='navy',      linestyle='--', label='NDVI = 0')
axes[1].axvline(0.3, color='darkgreen', linestyle='--', label='NDVI = 0.3')
axes[1].set_xlabel('NDVI')
axes[1].set_ylabel('Pixels')
axes[1].set_title('Distribution des valeurs NDVI')
axes[1].legend()

plt.tight_layout()
plt.show()

# Sauvegarde
meta_ndvi = meta_ref.copy()
meta_ndvi.update({'dtype': 'float32', 'count': 1})
with rasterio.open('rasters/output/NDVI_Ticino1990.tif', 'w', **meta_ndvi) as dst:
    dst.write(ndvi.astype(np.float32), 1)
print("NDVI sauvegardé : rasters/output/NDVI_Ticino1990.tif")
NDVI — min=-1.000, max=1.000, moy=0.357
NDVI sauvegardé : rasters/output/NDVI_Ticino1990.tif
Partie 4 — Reclassification de l’occupation du sol¶
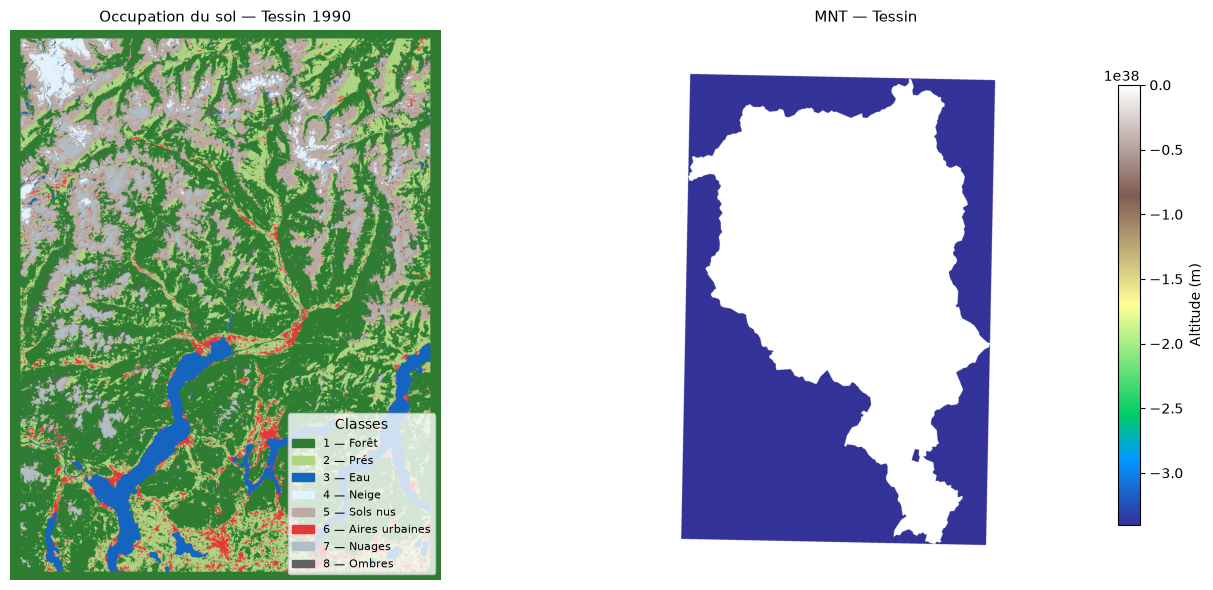
4.1 Chargement et visualisation¶
Le fichier MapTicino1990_8classes.tif contient 8 classes :
| Valeur | Classe |
|---|---|
| 1 | Forêt |
| 2 | Prés |
| 3 | Eau |
| 4 | Neige |
| 5 | Sols nus |
| 6 | Aires urbaines |
| 7 | Nuages |
| 8 | Ombres |
with rasterio.open(LANDCOVER_FILE) as src:
    landcover = src.read(1)
    meta_lc   = src.meta.copy()

# Le MNT est en EPSG:21781 (LV03) ; on le reprojette sur la grille de la carte d'occupation du sol
with rasterio.open(MNT_FILE) as src_mnt:
    mnt = np.empty((meta_lc['height'], meta_lc['width']), dtype=np.float32)
    reproject(
        source=src_mnt.read(1).astype(np.float32),
        destination=mnt,
        src_transform=src_mnt.transform,
        src_crs=src_mnt.crs,
        dst_transform=meta_lc['transform'],
        dst_crs=meta_lc['crs'],
        resampling=Resampling.bilinear,
    )

print(f"Occupation du sol : {landcover.shape}")
print(f"MNT reprojeté     : {mnt.shape}  (même grille que l'occupation du sol)")

CLASSES = {1: 'Forêt', 2: 'Prés', 3: 'Eau', 4: 'Neige',
           5: 'Sols nus', 6: 'Aires urbaines', 7: 'Nuages', 8: 'Ombres'}
COLORS  = ['#2e7d32', '#aed581', '#1565c0', '#e3f2fd',
           '#bcaaa4', '#e53935', '#b0bec5', '#616161']

print("\nDistribution des classes (avant reclassification) :")
n_total = landcover.size
for val, nom in CLASSES.items():
    n = (landcover == val).sum()
    print(f"  Classe {val} ({nom:15s}) : {n:8d} pixels  ({100*n/n_total:.1f} %)")

cmap_lc = mcolors.ListedColormap(COLORS)
norm_lc = mcolors.BoundaryNorm(range(1, 10), cmap_lc.N)
patches = [Patch(color=COLORS[i], label=f"{i+1} — {CLASSES[i+1]}") for i in range(8)]

fig, axes = plt.subplots(1, 2, figsize=(14, 6))

axes[0].imshow(landcover, cmap=cmap_lc, norm=norm_lc, origin='upper')
axes[0].legend(handles=patches, loc='lower right', fontsize=8, title='Classes')
axes[0].set_title('Occupation du sol — Tessin 1990', fontsize=11)
axes[0].axis('off')

im = axes[1].imshow(mnt, cmap='terrain', origin='upper')
plt.colorbar(im, ax=axes[1], label='Altitude (m)', shrink=0.8)
axes[1].set_title('MNT — Tessin', fontsize=11)
axes[1].axis('off')

plt.tight_layout()
plt.show()
Occupation du sol : (3456, 2707)
MNT reprojeté : (3456, 2707) (même grille que l'occupation du sol)
Distribution des classes (avant reclassification) :
Classe 1 (Forêt ) : 4200598 pixels (44.9 %)
Classe 2 (Prés ) : 1513422 pixels (16.2 %)
Classe 3 (Eau ) : 470355 pixels (5.0 %)
Classe 4 (Neige ) : 159060 pixels (1.7 %)
Classe 5 (Sols nus ) : 1458456 pixels (15.6 %)
Classe 6 (Aires urbaines ) : 320292 pixels (3.4 %)
Classe 7 (Nuages ) : 380119 pixels (4.1 %)
Classe 8 (Ombres ) : 126523 pixels (1.4 %)
4.2 Reclassification conditionnelle¶
Dans QGIS tu utilisais la Calculatrice Raster :
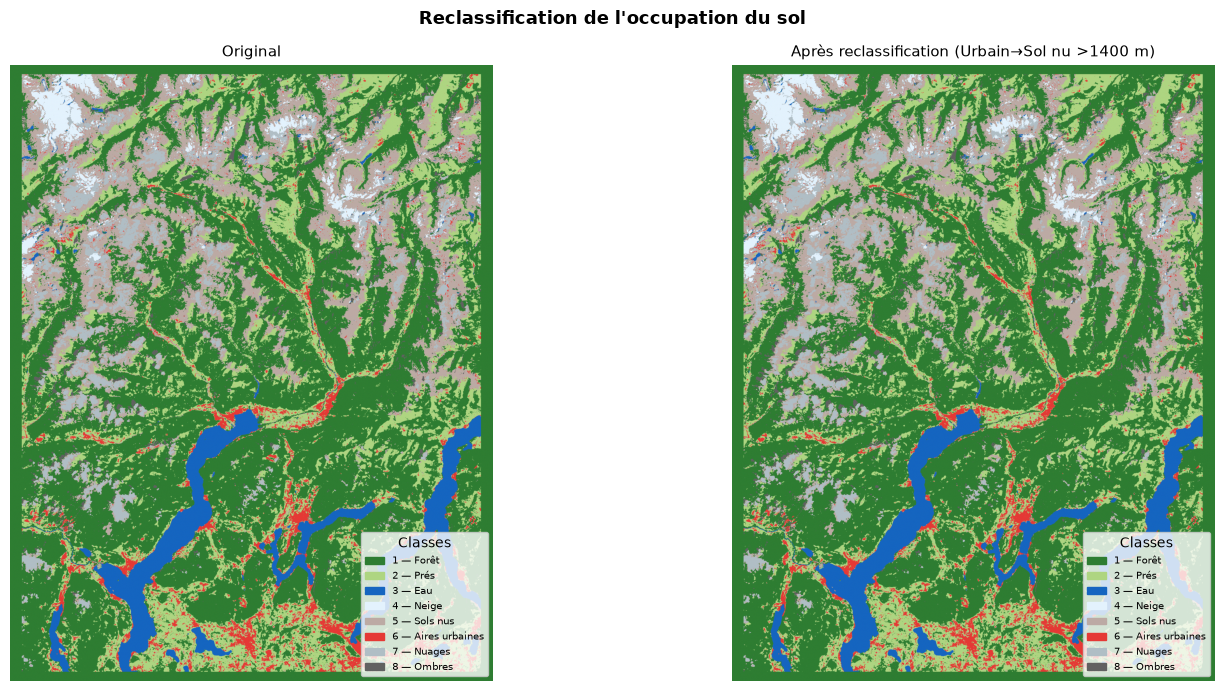
if( (MNT > 1400) AND (classes = 6), 5, classes )En Python : np.where() avec deux conditions combinées par &.
But : corriger les pixels classés Aires urbaines (6) en altitude > 1 400 m → les reclasser en Sols nus (5) car la confusion vient de signatures spectrales similaires entre béton et rochers.
# Reclassification : Aires urbaines (6) au-dessus de 1400 m → Sols nus (5)
# Équivalent QGIS : if( (MNT > 1400) AND (classes = 6), 5, classes )
condition = (mnt > 1400) & (landcover == 6)

landcover_reclass = np.where(condition, 5, landcover)

n_corriges = condition.sum()
print(f"Pixels reclassifiés (Urbain→Sol nu, altitude >1400 m) : {n_corriges}")
print()
print("Distribution après reclassification :")
for val, nom in CLASSES.items():
    n_avant = (landcover == val).sum()
    n_apres = (landcover_reclass == val).sum()
    diff = n_apres - n_avant
    marker = f"  ({diff:+d})" if diff != 0 else ""
    print(f"  Classe {val} ({nom:15s}) : {n_apres:8d} pixels{marker}")

fig, axes = plt.subplots(1, 2, figsize=(16, 7))
for ax, data, title in [
    (axes[0], landcover,         'Original'),
    (axes[1], landcover_reclass, 'Après reclassification (Urbain→Sol nu >1400 m)'),
]:
    ax.imshow(data, cmap=cmap_lc, norm=norm_lc, origin='upper')
    ax.legend(handles=patches, loc='lower right', fontsize=7, title='Classes')
    ax.set_title(title, fontsize=11)
    ax.axis('off')

plt.suptitle("Reclassification de l'occupation du sol", fontsize=13, fontweight='bold')
plt.tight_layout()
plt.show()

# Sauvegarde
with rasterio.open('rasters/output/ReClass_MapTicino1990_8classes.tif', 'w', **meta_lc) as dst:
    dst.write(landcover_reclass.astype(meta_lc['dtype']), 1)
print("Reclassifié sauvegardé : rasters/output/ReClass_MapTicino1990_8classes.tif")
Pixels reclassifiés (Urbain→Sol nu, altitude >1400 m) : 9985

Distribution après reclassification :
  Classe 1 (Forêt          ) :  4200598 pixels
  Classe 2 (Prés           ) :  1513422 pixels
  Classe 3 (Eau            ) :   470355 pixels
  Classe 4 (Neige          ) :   159060 pixels
  Classe 5 (Sols nus       ) :  1468441 pixels  (+9985)
  Classe 6 (Aires urbaines ) :   310307 pixels  (-9985)
  Classe 7 (Nuages         ) :   380119 pixels
  Classe 8 (Ombres         ) :   126523 pixels
Reclassifié sauvegardé : rasters/output/ReClass_MapTicino1990_8classes.tif
Partie 5 — Interpolation IDW¶
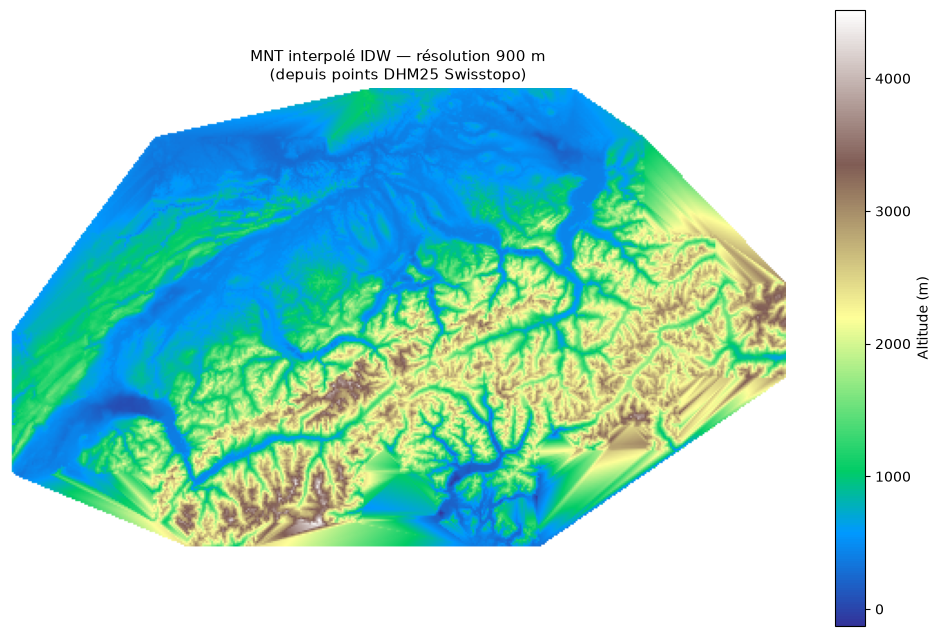
L’interpolation IDW prédit la valeur en tout point depuis des mesures ponctuelles.
Dans QGIS : outil IDW sur les points DHM25 de Swisstopo (résolution 900 m).
En Python : scipy.interpolate.griddata.
pts = gpd.read_file(DHM25_PATH)
print(f"Points chargés : {len(pts)}")
print(f"Colonnes       : {pts.columns.tolist()}")
print(f"CRS            : {pts.crs}")
print(pts.head(3))
Points chargés : 209505
Colonnes : ['OBJECTID', 'OBJECTVAL', 'OBJECTORIG', 'YEAROFCHAN', 'geometry']
CRS : EPSG:21781
OBJECTID OBJECTVAL OBJECTORIG YEAROFCHAN \
0 8561055 Hoehenkote LK25 1987
1 8561059 Hoehenkote LK25 1987
2 8561134 Hoehenkote LK25 1981
geometry
0 POINT Z (559145.3 242445.3 715)
1 POINT Z (560184.4 242995.3 725)
2 POINT Z (579737.5 253873.4 523)
# L'altitude est encodée dans la coordonnée Z de la géométrie POINT Z
xy_pts = np.column_stack([pts.geometry.x, pts.geometry.y])
z_pts  = pts.geometry.z.values

# Grille cible (résolution 900 m)
RES = 900
bounds = pts.total_bounds   # [xmin, ymin, xmax, ymax]
xi = np.arange(bounds[0], bounds[2], RES)
yi = np.arange(bounds[1], bounds[3], RES)
XX, YY = np.meshgrid(xi, yi)

# Interpolation linéaire (équivalent IDW local)
mnt_idw = griddata(xy_pts, z_pts, (XX, YY), method='linear')
mnt_idw = np.flipud(mnt_idw)   # convention raster : ligne 0 en haut

print(f"MNT interpolé : {mnt_idw.shape}  —  résolution {RES} m")
print(f"Altitude : min={np.nanmin(mnt_idw):.0f} m, max={np.nanmax(mnt_idw):.0f} m")

fig, ax = plt.subplots(figsize=(10, 8))
im = ax.imshow(mnt_idw, cmap='terrain', origin='upper')
plt.colorbar(im, ax=ax, label='Altitude (m)', shrink=0.8)
ax.set_title(f'MNT interpolé IDW — résolution {RES} m\n(depuis points DHM25 Swisstopo)', fontsize=11)
ax.axis('off')
plt.tight_layout()
plt.show()

# Sauvegarde
idw_transform = from_bounds(bounds[0], bounds[1], bounds[2], bounds[3],
                             mnt_idw.shape[1], mnt_idw.shape[0])
with rasterio.open(
    'rasters/output/MNT_IDW_900m.tif', 'w',
    driver='GTiff', height=mnt_idw.shape[0], width=mnt_idw.shape[1],
    count=1, dtype='float32', crs=pts.crs, transform=idw_transform,
) as dst:
    dst.write(mnt_idw.astype(np.float32), 1)
print("MNT IDW sauvegardé : rasters/output/MNT_IDW_900m.tif")
MNT interpolé : (254, 428) — résolution 900 m
Altitude : min=-128 m, max=4515 m
MNT IDW sauvegardé : rasters/output/MNT_IDW_900m.tif
Partie 6 — Ombrage (Hillshade)¶
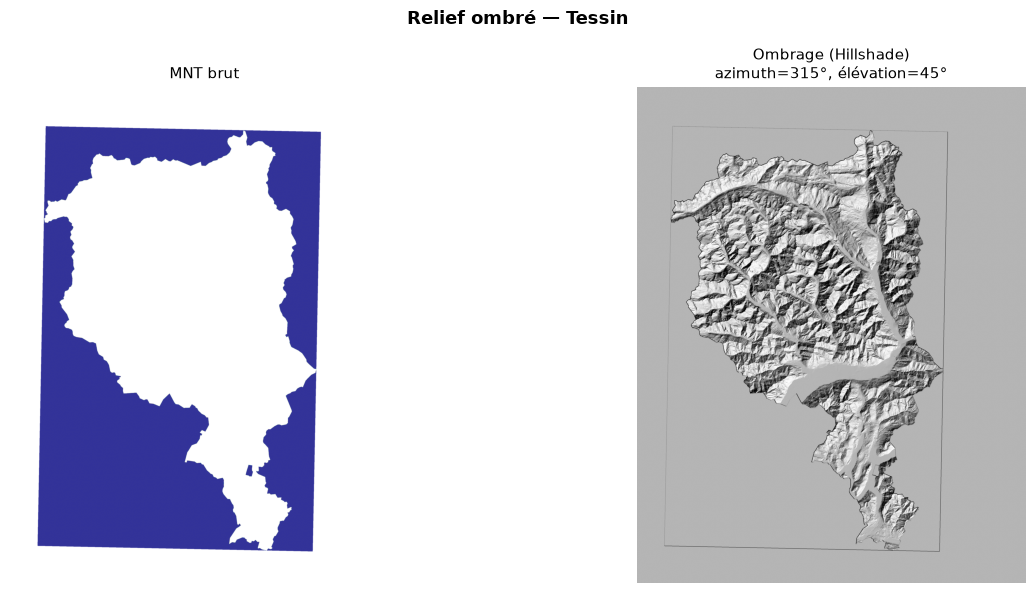
Dans QGIS : Raster > Analysis > Ombrage (azimut 315°, élévation 45°). En Python : on calcule le gradient du MNT, puis la pente, l’exposition et le produit scalaire avec la direction solaire.
def hillshade(dem, res=25, azimuth=315, altitude=45):
    """Calcule l'ombrage depuis un MNT NumPy.
    azimuth  : direction de la lumière (degrés depuis le Nord, sens horaire)
    altitude : angle d'élévation de la source lumineuse (degrés)
    """
    az_rad  = np.radians(360 - azimuth + 90)
    alt_rad = np.radians(altitude)

    dy, dx = np.gradient(dem, res, res)
    slope  = np.arctan(np.sqrt(dx**2 + dy**2))
    aspect = np.arctan2(-dy, dx)

    hs = (np.sin(alt_rad) * np.cos(slope) +
          np.cos(alt_rad) * np.sin(slope) * np.cos(az_rad - aspect))
    return np.clip(hs, 0, 1)

# Le MNT reprojeté a la résolution de la carte d'occupation du sol (~31 m)
mnt_res = meta_lc['transform'].a   # taille du pixel en x
hs = hillshade(mnt, res=mnt_res)

fig, axes = plt.subplots(1, 2, figsize=(14, 6))

axes[0].imshow(mnt, cmap='terrain', origin='upper')
axes[0].set_title('MNT brut', fontsize=11)
axes[0].axis('off')

axes[1].imshow(hs, cmap='gray', vmin=0, vmax=1, origin='upper')
axes[1].set_title('Ombrage (Hillshade)\nazimuth=315°, élévation=45°', fontsize=11)
axes[1].axis('off')

plt.suptitle('Relief ombré — Tessin', fontsize=13, fontweight='bold')
plt.tight_layout()
plt.show()

# Sauvegarde
meta_hs = meta_ref.copy()
meta_hs.update({'dtype': 'float32', 'count': 1})
with rasterio.open('rasters/output/Hillshade_Ticino.tif', 'w', **meta_hs) as dst:
    dst.write(hs.astype(np.float32), 1)
print("Hillshade sauvegardé : rasters/output/Hillshade_Ticino.tif")
/tmp/ipykernel_107251/90092553.py:10: RuntimeWarning: overflow encountered in square
slope = np.arctan(np.sqrt(dx**2 + dy**2))
Hillshade sauvegardé : rasters/output/Hillshade_Ticino.tif
Partie 7 — Classification de l’occupation du sol avec RF, XGBoost et MLP¶
Contexte et objectif¶
Les parties précédentes ont produit plusieurs couches raster alignées. On peut maintenant traiter chaque pixel comme une observation et entraîner un modèle de classification — l’une des tâches les plus courantes en télédétection.
| Rôle | Variable | Source |
|---|---|---|
| Cible | Classe d’occupation du sol (1–6) | MapTicino1990_8classes.tif |
| Prédicteurs | Réflectances Landsat (7 bandes) | Parties 1–3 |
| Prédicteur | Altitude (m) | MNT reprojeté (Partie 4) |
Progression par rapport aux TP précédents :
| TP | Modèles | Nouveauté |
|---|---|---|
| TP02 | Régression OLS | R²/r, IC vs IP, surapprentissage, split entraînement/test |
| TP03 | Polynomiale, GLM, GAM | Non-linéarité, lisseur spatial, K-fold CV, incertitude du R² CV |
| TP04 | RF, XGBoost, MLP | Modèles non-paramétriques, jeu de validation, prédiction conforme |
Les modèles précédents (TP02–TP03) sont tous paramétriques : ils reposent sur une forme mathématique fixée à l’avance (une droite, un polynôme, une somme de splines) dont on estime les paramètres. Random Forest, XGBoost et le MLP (Multi-Layer Perceptron, un petit réseau de neurones) sont non-paramétriques — leur complexité s’adapte aux données plutôt que d’être fixée par une formule.
Ce qu’on va faire, dans l’ordre :
Préparer les données (§7.1) — une matrice de features par pixel (bandes + altitude).
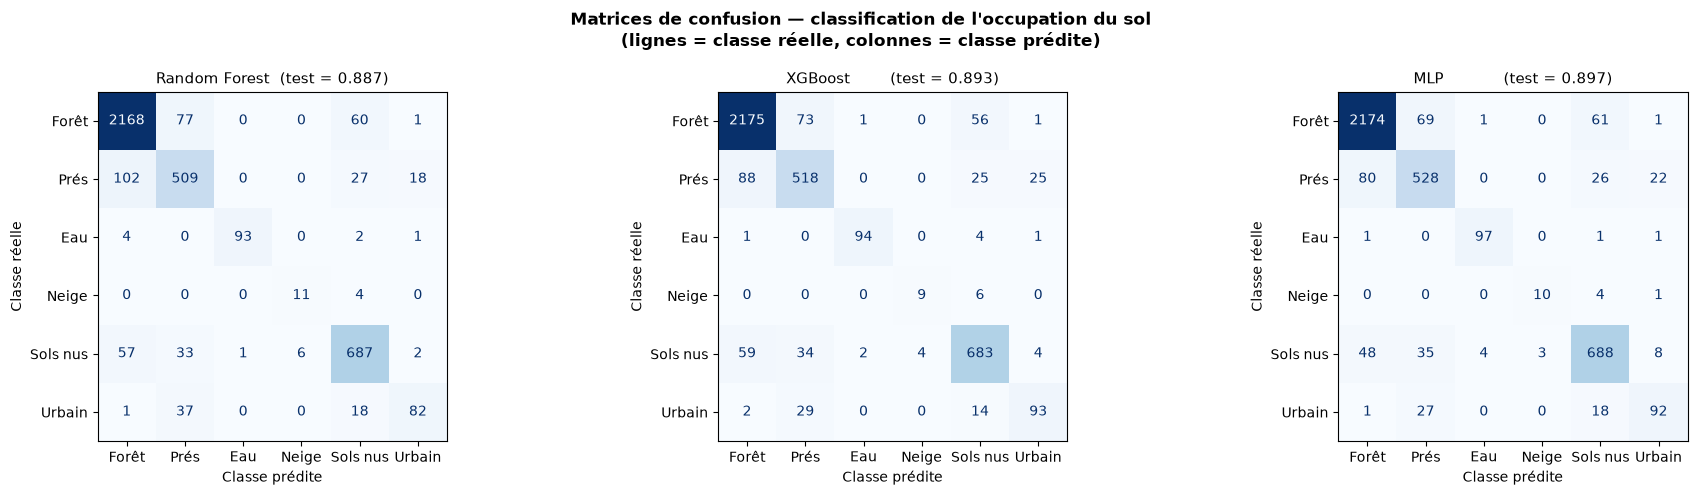
Entraîner trois modèles candidats (RF, XGBoost, MLP) et choisir le meilleur sur un jeu de validation dédié, sans jamais regarder le jeu de test avant la toute fin (§7.2).
Comparer leurs importances de variables (§7.3).
Quantifier la fiabilité du modèle retenu par prédiction conforme (§7.4) : au lieu d’une seule classe prédite par pixel, on obtiendra un ensemble de classes plausibles, avec une garantie statistique du type « la vraie classe est dans l’ensemble au moins 90 % du temps ».
Les étapes 2 et 4 demandent chacune un jeu de données à part — d’où la séparation en quatre jeux dès le début de la §7.2.
ℹ️ Cible utilisée : la classification ci-dessous prend comme vérité terrain la carte d’occupation du sol originale (
landcover, classes 1–6). La reclassification de la §4.2 (landcover_reclass) était une démonstration d’édition raster (Calculatrice Raster), pas la cible du modèle.
7.1 Préparation des données — matrice de features par pixel¶
On reprojette les 7 bandes Landsat sur la grille de l’occupation du sol, puis on construit, pour un sous-échantillon de 20 000 pixels valides, une matrice de 8 features (7 réflectances + altitude) et le vecteur cible (classe 1–6).
from sklearn.ensemble import RandomForestClassifier
from sklearn.preprocessing import LabelEncoder
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, ConfusionMatrixDisplay
import xgboost as xgb

LC_NAMES  = {1: 'Forêt', 2: 'Prés', 3: 'Eau', 4: 'Neige', 5: 'Sols nus', 6: 'Urbain'}
LC_COLORS = {1: '#2e7d32', 2: '#aed581', 3: '#1565c0', 4: '#e3f2fd', 5: '#bcaaa4', 6: '#e53935'}
BAND_NAMES = ['B1-Bleu', 'B2-Vert', 'B3-Rouge', 'B4-PIR', 'B5-SWIR1', 'B6-Therm', 'B7-SWIR2']

# 1. Rééchantillonner les 7 bandes Landsat sur la grille de l'occupation du sol
print("Rééchantillonnage des 7 bandes Landsat sur la grille de l'occupation du sol...")
bands_on_lc = []
for i, path in enumerate(BAND_FILES):
    band = np.empty((meta_lc['height'], meta_lc['width']), dtype=np.float32)
    with rasterio.open(path) as src:
        reproject(
            source=src.read(1).astype(np.float32),
            destination=band,
            src_transform=src.transform,
            src_crs=src.crs,
            dst_transform=meta_lc['transform'],
            dst_crs=meta_lc['crs'],
            resampling=Resampling.bilinear,
        )
    bands_on_lc.append(band)
    print(f"  {BAND_NAMES[i]:12s} rééchantillonné")

ls_on_lc = np.stack(bands_on_lc, axis=0)   # (7, H, W)
print(f"\nImage rééchantillonnée : {ls_on_lc.shape}  (bandes × lignes × colonnes)")

# 2. Masque : classes valides 1–6, toutes bandes finies et > 0, MNT positif
valid_clf = (
    np.isin(landcover, [1, 2, 3, 4, 5, 6]) &
    np.all(np.isfinite(ls_on_lc) & (ls_on_lc > 0), axis=0) &
    np.isfinite(mnt) & (mnt > 0)
)
print(f"Pixels valides : {valid_clf.sum():,} / {valid_clf.size:,} ({100*valid_clf.mean():.1f} %)")

# 3. Sous-échantillonnage aléatoire : 20 000 pixels
rng = np.random.default_rng(42)
idx_valid_clf = np.argwhere(valid_clf)
chosen = rng.choice(len(idx_valid_clf), 20_000, replace=False)
rows_clf, cols_clf = idx_valid_clf[chosen, 0], idx_valid_clf[chosen, 1]

# 4. Features : 7 bandes + MNT (8 features par pixel)
X_clf = np.column_stack([
    ls_on_lc[:, rows_clf, cols_clf].T,   # (20000, 7)
    mnt[rows_clf, cols_clf],              # (20000,)
])
y_clf = landcover[rows_clf, cols_clf]    # labels 1–6

feat_names_clf = BAND_NAMES + ['MNT']
print(f"\nFeatures ({X_clf.shape[1]}) : {feat_names_clf}")
print(f"Taille du jeu de données : {len(X_clf):,} pixels\n")
print("Distribution des classes :")
for v in sorted(LC_NAMES):
    n = (y_clf == v).sum()
    print(f"  {v} – {LC_NAMES[v]:15s} : {n:5d} pixels ({100*n/len(y_clf):.1f} %)")
Rééchantillonnage des 7 bandes Landsat sur la grille de l'occupation du sol...
B1-Bleu rééchantillonné
B2-Vert rééchantillonné
B3-Rouge rééchantillonné
B4-PIR rééchantillonné
B5-SWIR1 rééchantillonné
B6-Therm rééchantillonné
  B7-SWIR2     rééchantillonné

Image rééchantillonnée : (7, 3456, 2707)  (bandes × lignes × colonnes)
Pixels valides : 2,696,468 / 9,355,392 (28.8 %)

Features (8) : ['B1-Bleu', 'B2-Vert', 'B3-Rouge', 'B4-PIR', 'B5-SWIR1', 'B6-Therm', 'B7-SWIR2', 'MNT']
Taille du jeu de données : 20,000 pixels

Distribution des classes :
  1 – Forêt           : 11461 pixels (57.3 %)
  2 – Prés            :  3275 pixels (16.4 %)
  3 – Eau             :   537 pixels (2.7 %)
  4 – Neige           :    83 pixels (0.4 %)
  5 – Sols nus        :  3936 pixels (19.7 %)
  6 – Urbain          :   708 pixels (3.5 %)
7.2 Séparation en quatre jeux — entraînement / validation / calibration / test¶
Jusqu’ici (TP02–TP03), un seul modèle était ajusté à la fois : un split entraînement/test (ou une CV) suffisait à estimer sa généralisation. Ici, on compare trois modèles candidats (RF, XGBoost, MLP) et on veut, en plus, mesurer la fiabilité du modèle retenu. Cela demande quatre jeux disjoints, chacun avec un rôle strict :
| Jeu | Rôle | Part |
|---|---|---|
| Entraînement | Ajuster les paramètres de chaque modèle | 50 % |
| Validation | Choisir lequel des trois modèles garder (jamais vu pendant l’entraînement) | 15 % |
| Calibration | Mesurer, après coup, à quel point les probabilités du modèle retenu sont fiables (§7.4) | 15 % |
| Test | Évaluation finale, indépendante de toutes les décisions précédentes | 20 % |
⚠️ Utiliser le jeu de test pour choisir un modèle (« je regarde l’accuracy de test des 3 modèles et je garde le meilleur ») invalide l’évaluation finale : le test n’est alors plus vraiment « jamais vu ». C’est exactement pour éviter ça que le jeu de validation existe.
Pourquoi un quatrième jeu, la calibration ? Un modèle de classification ne donne pas seulement une classe prédite, mais une probabilité pour chaque classe (predict_proba). Ces probabilités ne sont pas parfaitement fiables : un modèle peut se dire « sûr à 95 % » et se tromper bien plus souvent que 5 % du temps. La prédiction conforme (§7.4) corrige cela en observant, sur le jeu de calibration, à quel point le modèle se trompe réellement — puis s’en sert pour construire, pour chaque nouveau pixel, un ensemble de classes plausibles plutôt qu’une seule réponse, avec une garantie de couverture. La calibration doit rester distincte de la validation : la validation sert à choisir le modèle, la calibration sert seulement à mesurer sa fiabilité une fois ce choix fait.
Le MLP (MLPClassifier), contrairement aux arbres (RF, XGBoost), est sensible à l’échelle des variables : les réflectances Landsat (≈ 0–1) et l’altitude MNT (≈ 0–3000 m) ont des échelles très différentes, ce qui déséquilibre l’apprentissage d’un réseau de neurones. On standardise donc les features (StandardScaler) avant le MLP, dans un Pipeline — étape inutile, et donc omise, pour RF et XGBoost.
from sklearn.neural_network import MLPClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline

# --- Séparation 50 / 15 / 15 / 20 (entraînement / validation / calibration / test) ---
frac_train, frac_val, frac_cal, frac_test = 0.50, 0.15, 0.15, 0.20
idx_all = np.arange(len(X_clf))

idx_tr, idx_rest  = train_test_split(idx_all,  test_size=1 - frac_train, random_state=42)
idx_val, idx_rest2 = train_test_split(idx_rest, test_size=(frac_cal + frac_test) / (1 - frac_train), random_state=0)
idx_cal, idx_te    = train_test_split(idx_rest2, test_size=frac_test / (frac_cal + frac_test), random_state=1)

X_tr, X_val, X_cal, X_te = X_clf[idx_tr], X_clf[idx_val], X_clf[idx_cal], X_clf[idx_te]
y_tr, y_val, y_cal, y_te = y_clf[idx_tr], y_clf[idx_val], y_clf[idx_cal], y_clf[idx_te]
rows_te, cols_te = rows_clf[idx_te], cols_clf[idx_te]

print(f"Entraînement : {len(X_tr):,}   Validation : {len(X_val):,}   "
      f"Calibration : {len(X_cal):,}   Test : {len(X_te):,}")

# --- Random Forest ---
rf = RandomForestClassifier(n_estimators=200, max_depth=15, random_state=42, n_jobs=-1).fit(X_tr, y_tr)

# --- XGBoost (labels obligatoirement 0-indexés en version ≥ 3) ---
le = LabelEncoder()
y_tr_enc = le.fit_transform(y_tr)                          # 1-6 → 0-5
xgb_clf = xgb.XGBClassifier(
    n_estimators=200, max_depth=6, learning_rate=0.1,
    random_state=42, eval_metric='mlogloss', verbosity=0
).fit(X_tr, y_tr_enc)

# --- MLP : Pipeline avec standardisation (voir §7.2) ---
mlp = make_pipeline(
    StandardScaler(),
    MLPClassifier(hidden_layer_sizes=(32, 16), max_iter=500, random_state=42)
).fit(X_tr, y_tr)

# models[name] = (modèle, encodeur ou None) — l'encodeur ramène XGBoost à l'échelle 1-6
models = {'Random Forest': (rf, None), 'XGBoost': (xgb_clf, le), 'MLP': (mlp, None)}

def predict_labels(name, X):
    model, enc = models[name]
    pred = model.predict(X)
    return enc.inverse_transform(pred) if enc is not None else pred

# --- Sélection de modèle sur le jeu de VALIDATION (jamais utilisé pour l'entraînement) ---
print("\nSélection de modèle — précision sur le jeu de validation :")
val_acc = {}
for name in models:
    val_acc[name] = accuracy_score(y_val, predict_labels(name, X_val))
    print(f"  {name:15s} : {val_acc[name]:.3f}")

best_name = max(val_acc, key=val_acc.get)
print(f"\n→ Modèle retenu (validation la plus élevée) : {best_name}")

# --- Évaluation finale sur le jeu de TEST, pour les trois modèles (comparaison) ---
y_pred_rf  = predict_labels('Random Forest', X_te)
y_pred_xgb = predict_labels('XGBoost', X_te)
y_pred_mlp = predict_labels('MLP', X_te)
acc_rf  = accuracy_score(y_te, y_pred_rf)
acc_xgb = accuracy_score(y_te, y_pred_xgb)
acc_mlp = accuracy_score(y_te, y_pred_mlp)

class_labels = [LC_NAMES[v] for v in sorted(LC_NAMES)]

fig, axes = plt.subplots(1, 3, figsize=(19, 5))
for ax, preds, title in [
    (axes[0], y_pred_rf,  f'Random Forest  (test = {acc_rf:.3f})'),
    (axes[1], y_pred_xgb, f'XGBoost        (test = {acc_xgb:.3f})'),
    (axes[2], y_pred_mlp, f'MLP            (test = {acc_mlp:.3f})'),
]:
    ConfusionMatrixDisplay.from_predictions(
        y_te, preds, display_labels=class_labels,
        cmap='Blues', ax=ax, colorbar=False
    )
    ax.set_title(title, fontsize=11)
    ax.set_xlabel('Classe prédite')
    ax.set_ylabel('Classe réelle')

plt.suptitle("Matrices de confusion — classification de l'occupation du sol\n"
             "(lignes = classe réelle, colonnes = classe prédite)", fontsize=12, fontweight='bold')
plt.tight_layout()
plt.show()
Entraînement : 10,000 Validation : 3,000 Calibration : 2,999 Test : 4,001
Sélection de modèle — précision sur le jeu de validation :
  Random Forest   : 0.895
  XGBoost         : 0.896
  MLP             : 0.898

→ Modèle retenu (validation la plus élevée) : MLP
7.3 Importances des variables¶
RF et XGBoost exposent nativement .feature_importances_ (basé sur la réduction d’impureté apportée par chaque variable dans les arbres). Le MLP n’a pas d’équivalent direct : ses poids sont distribués sur des couches cachées et ne s’interprètent pas variable par variable de la même façon — c’est un des compromis des réseaux de neurones (performance vs interprétabilité directe).
# --- Importances des variables ---
fig, axes = plt.subplots(1, 2, figsize=(14, 5))

for ax, imp, title, color in [
    (axes[0], rf.feature_importances_,      f'Random Forest  (acc = {acc_rf:.3f})',  '#42a5f5'),
    (axes[1], xgb_clf.feature_importances_, f'XGBoost        (acc = {acc_xgb:.3f})', '#ef6c00'),
]:
    order = np.argsort(imp)
    ax.barh(
        [feat_names_clf[i] for i in order], imp[order],
        color=color, alpha=0.85, edgecolor='white'
    )
    ax.set_xlabel('Importance relative')
    ax.set_title(title, fontsize=11)
    ax.grid(True, alpha=0.3, axis='x')

plt.suptitle('Importances des variables prédictives\n'
             '(quelle bande aide le plus à distinguer les classes ?)',
             fontsize=12, fontweight='bold')
plt.tight_layout()
plt.show()

print("Classement RF — de la plus à la moins importante :")
for i in np.argsort(rf.feature_importances_)[::-1]:
    print(f"  {feat_names_clf[i]:12s} : {rf.feature_importances_[i]:.4f}")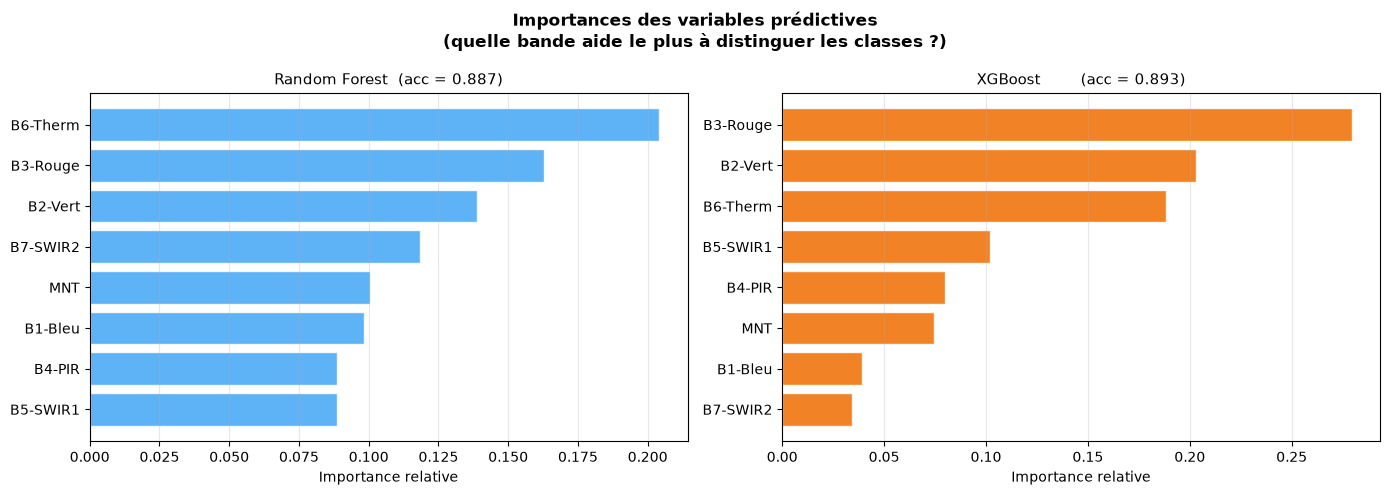
Classement RF — de la plus à la moins importante :
  B6-Therm     : 0.2041
  B3-Rouge     : 0.1627
  B2-Vert      : 0.1389
  B7-SWIR2     : 0.1184
  MNT          : 0.1003
  B1-Bleu      : 0.0984
  B4-PIR       : 0.0887
  B5-SWIR1     : 0.0886
7.4 Prédiction conforme (classification)¶
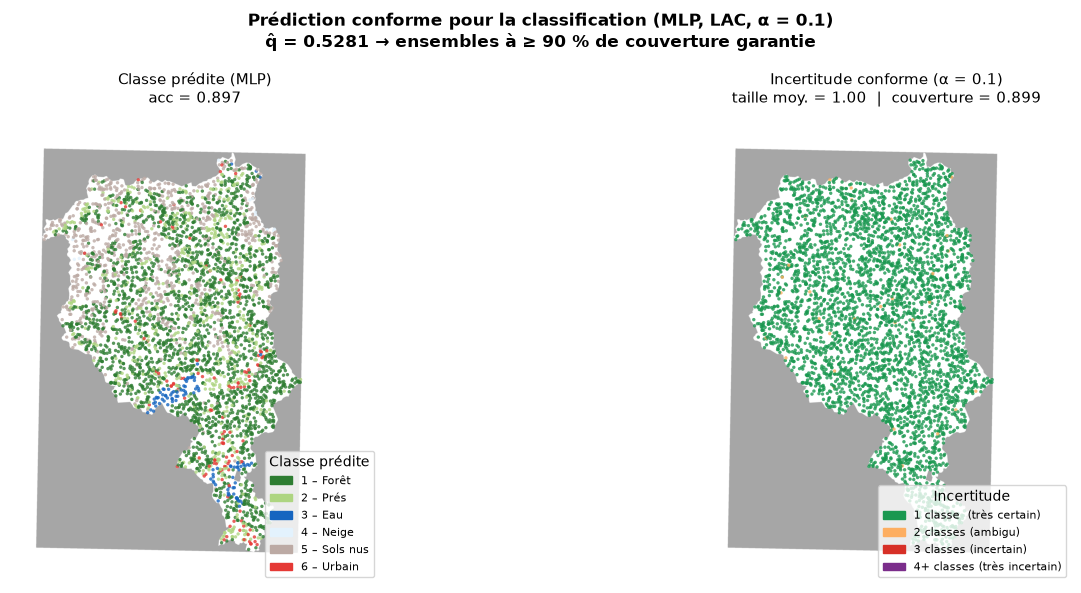
On met en œuvre ici le principe présenté en §7.2 : mesurer la fiabilité du modèle retenu (best_name) sur le jeu de calibration, puis construire des ensembles de classes avec une couverture garantie.
from math import ceil

alpha = 0.10   # couverture cible : 90 %
best_model, best_enc = models[best_name]

# 1. Scores de non-conformité sur le jeu de calibration
#    Méthode LAC (Least Ambiguous Classifier) : score = 1 – P(vraie classe | x)
#    Un score proche de 0 signifie que le modèle est confiant et correct.
#    Un score proche de 1 signifie que le modèle a attribué très peu de probabilité
#    à la vraie classe (erreur ou incertitude élevée).
proba_cal = best_model.predict_proba(X_cal)                                  # (n_cal, 6)
# best_enc.inverse_transform(best_model.classes_) remet XGBoost à l'échelle 1-6 ;
# pour RF/MLP, .classes_ est déjà dans cette échelle (best_enc = None).
classes_best = best_enc.inverse_transform(best_model.classes_) if best_enc is not None else best_model.classes_
true_idx_cal = np.array([np.where(classes_best == yc)[0][0] for yc in y_cal])
scores_cal = 1.0 - proba_cal[np.arange(len(y_cal)), true_idx_cal]

# 2. Quantile q̂ avec correction finie — garantie de couverture exacte
n_cal = len(scores_cal)
q_hat = np.quantile(scores_cal, ceil((n_cal + 1) * (1 - alpha)) / n_cal)
print(f"Modèle utilisé : {best_name}")
print(f"n_cal = {n_cal:,}")
print(f"q̂    = {q_hat:.4f}  →  on retient toutes les classes avec P(classe|x) ≥ {1-q_hat:.4f}")

# 3. Ensembles de prédiction sur le test
proba_te  = best_model.predict_proba(X_te)   # (n_te, 6)
pred_sets = proba_te >= (1.0 - q_hat)        # booléen (n_te, 6)
set_sizes = pred_sets.sum(axis=1)            # taille de l'ensemble pour chaque pixel

# 4. Couverture empirique : la vraie classe est-elle dans l'ensemble ?
true_idx_te = np.array([np.where(classes_best == yc)[0][0] for yc in y_te])
covered     = pred_sets[np.arange(len(y_te)), true_idx_te]

print(f"\nCouverture empirique  : {covered.mean():.3f}  (cible ≥ {1-alpha:.2f})")
print(f"Taille moy. ensemble  : {set_sizes.mean():.2f} classes / pixel")
print(f"\nDistribution des tailles d'ensemble :")
for sz in sorted(np.unique(set_sizes)):
    n = (set_sizes == sz).sum()
    print(f"  {sz} classe(s) : {n:5d} pixels ({100*n/len(set_sizes):.1f} %)")

# 5. Visualisation : carte des prédictions + carte d'incertitude conforme
y_pred_best = predict_labels(best_name, X_te)
acc_best = accuracy_score(y_te, y_pred_best)

fig, axes = plt.subplots(1, 2, figsize=(16, 6))

# Panneau gauche : classe la plus probable du modèle retenu (fond MNT)
axes[0].imshow(mnt, cmap='gray', origin='upper', alpha=0.35)
axes[0].scatter(
    cols_te, rows_te,
    c=y_pred_best,
    cmap=mcolors.ListedColormap([LC_COLORS[v] for v in sorted(LC_NAMES)]),
    vmin=0.5, vmax=6.5, s=6, alpha=0.8, linewidths=0
)
patches_lc = [Patch(color=LC_COLORS[v], label=f'{v} – {LC_NAMES[v]}')
              for v in sorted(LC_NAMES)]
axes[0].legend(handles=patches_lc, loc='lower right', fontsize=8, title='Classe prédite')
axes[0].set_title(f'Classe prédite ({best_name})\nacc = {acc_best:.3f}', fontsize=11)
axes[0].set_xlim(0, mnt.shape[1])
axes[0].set_ylim(mnt.shape[0], 0)
axes[0].axis('off')

# Panneau droit : incertitude = taille de l'ensemble de prédiction conforme
size_cmap = mcolors.ListedColormap(['#1a9850', '#fdae61', '#d73027', '#7b2d8b'])
size_norm = mcolors.BoundaryNorm([0.5, 1.5, 2.5, 3.5, 6.5], size_cmap.N)
axes[1].imshow(mnt, cmap='gray', origin='upper', alpha=0.35)
axes[1].scatter(
    cols_te, rows_te,
    c=set_sizes, cmap=size_cmap, norm=size_norm,
    s=6, alpha=0.8, linewidths=0
)
size_patches = [
    Patch(color='#1a9850', label='1 classe  (très certain)'),
    Patch(color='#fdae61', label='2 classes (ambigu)'),
    Patch(color='#d73027', label='3 classes (incertain)'),
    Patch(color='#7b2d8b', label='4+ classes (très incertain)'),
]
axes[1].legend(handles=size_patches, loc='lower right', fontsize=8, title='Incertitude')
axes[1].set_title(
    f'Incertitude conforme (α = {alpha})\n'
    f'taille moy. = {set_sizes.mean():.2f}  |  couverture = {covered.mean():.3f}',
    fontsize=11
)
axes[1].set_xlim(0, mnt.shape[1])
axes[1].set_ylim(mnt.shape[0], 0)
axes[1].axis('off')

plt.suptitle(
    f'Prédiction conforme pour la classification ({best_name}, LAC, α = {alpha})\n'
    f'q̂ = {q_hat:.4f} → ensembles à ≥ {(1-alpha)*100:.0f} % de couverture garantie',
    fontsize=12, fontweight='bold'
)
plt.tight_layout()
plt.show()
Modèle utilisé : MLP
n_cal = 2,999
q̂ = 0.5281 → on retient toutes les classes avec P(classe|x) ≥ 0.4719
Couverture empirique : 0.899 (cible ≥ 0.90)
Taille moy. ensemble : 1.00 classes / pixel
Distribution des tailles d'ensemble :
0 classe(s) : 30 pixels (0.7 %)
1 classe(s) : 3940 pixels (98.5 %)
2 classe(s) : 31 pixels (0.8 %)
Récapitulatif¶
| Opération QGIS | Code Python clé |
|---|---|
| Propriétés de la couche | rasterio.open(f) → .crs, .bounds, .res, .meta |
| Merge (fusion de bandes) | np.stack(bands) + rasterio.open('w', count=N) |
| Composition colorée | np.dstack([r, g, b]) + normalisation percentile |
| Calculatrice raster (NDVI) | (nir - rouge) / (nir + rouge) |
| Calculatrice raster (if/and) | np.where((cond1) & (cond2), val_vrai, val_faux) |
| Reprojection raster | rasterio.warp.reproject(src, dst, src_crs=..., dst_crs=...) |
| Interpolation IDW | scipy.interpolate.griddata(xy, z, (XX,YY), method='linear') |
| Ombrage (Hillshade) | np.gradient(dem) → calcul slope / aspect / hillshade |
| Écrire un GeoTIFF | rasterio.open(path, 'w', **meta) → .write(array, band) |
Partie 7 — Classification ML sur pixels raster¶
| Étape | Code clé |
|---|---|
| Reprojection bandes Landsat | rasterio.warp.reproject(src, dst, dst_transform=meta_lc['transform'], ...) |
| Masque pixels valides | np.isin(lc, [1..6]) & np.all(ls > 0, axis=0) & (mnt > 0) |
| Sous-échantillonnage | np.random.default_rng(42).choice(n_valid, 20_000) |
| Matrice de features | np.column_stack([ls_on_lc[:, rows, cols].T, mnt[rows, cols]]) |
| Séparation 50/15/15/20 | train_test_split deux fois (train / val / cal / test) |
| Random Forest | RandomForestClassifier(n_estimators=200).fit(X_tr, y_tr) |
| XGBoost (0-indexé) | LabelEncoder() + XGBClassifier().fit(X_tr, y_tr_enc) |
| MLP (standardisé) | make_pipeline(StandardScaler(), MLPClassifier(...)).fit(X_tr, y_tr) |
| Sélection de modèle | comparer l’accuracy des 3 modèles sur X_val, jamais sur X_te |
| Matrice de confusion | ConfusionMatrixDisplay.from_predictions(y_te, y_pred, ...) |
| Importances RF / XGBoost | .feature_importances_ (MLP : pas d’équivalent direct) |
| Score conforme (LAC) | `scores = 1 – P(vraie_classe |
| Quantile conforme | q̂ = np.quantile(scores, ceil((n+1)(1–α)) / n) |
| Ensemble de prédiction | `pred_set = {classes k : P(k |
| Couverture empirique | (pred_set[i, true_class[i]]).mean() sur le test |
Concepts clés :
| Indicateur | Signification |
|---|---|
| Précision (accuracy) | Part des pixels correctement classés ∈ [0, 1] |
| Jeu de validation | Sert à choisir un modèle — jamais à l’entraîner ni à l’évaluer finalement |
| Jeu de calibration | Distinct de la validation — sert uniquement à calculer les scores conformes |
| Matrice de confusion | Tableau croisé classes réelles × prédites — révèle les confusions fréquentes |
| Importance des variables | Contribution de chaque bande/MNT à la qualité de classification (RF, XGBoost) |
| Score LAC | `1 – P(vraie classe |
| q̂ conforme | Seuil de probabilité : classe incluse si P(classe) ≥ 1 – q̂ |
| Taille de l’ensemble | 1 = pixel certain ; >1 = zones de transition (écotones, urbain/roc) |
| Couverture garantie | P(vraie classe ∈ ensemble) ≥ 1–α sans hypothèse distributionnelle |
🎯 Bonnes pratiques ML — niveau 3 : sélectionner et garantir¶
(rappel niveaux 1–2 : TP02 posait les fondamentaux — jamais évaluer sur l’entraînement, toujours benchmarker, choisir la bonne métrique, questionner la composition du split ; TP03 a ajouté comparer plusieurs modèles par une procédure commune (CV) et quantifier l’incertitude d’une estimation de performance (CV répétée, bootstrap).)
| Principe | Où on l’a vu |
|---|---|
| Avec plusieurs modèles candidats, un jeu de validation dédié — distinct du test et de la calibration — sert à choisir lequel garder | §7.2 |
| Ne pas choisir un modèle en regardant le jeu de test : cela invalide l’évaluation finale, même si la tentation est grande | §7.2 |
Une probabilité prédite (predict_proba) n’est pas automatiquement fiable ; la prédiction conforme donne une garantie de couverture mesurable, sans hypothèse sur sa distribution | §7.4 |
| L’importance des variables aide à interpréter un modèle (quelle bande contribue le plus), mais ne prouve pas une relation causale | §7.3 |
Avec ces trois niveaux, construits progressivement TP après TP, on a les réponses à trois questions que tout projet de modélisation pose — pas seulement la régression ou la classification :
| Question | Outils vus dans ce fil rouge |
|---|---|
| Quel modèle choisir ? | Comparer plusieurs candidats sur les mêmes données, avec la même métrique : tableau CV multi-modèles (TP03 §4.7), accuracy de validation (TP04 §7.2). Ne jamais choisir un modèle en regardant le jeu de test. |
| Comment le valider ? | Train/test simple (TP02 §6.5) → K-fold CV (TP03 §4.7) → jeu de validation dédié quand plusieurs modèles sont en compétition (TP04 §7.2). Toujours évaluer — et sélectionner — sur des données jamais vues. |
| Comment quantifier l’incertitude ? | IC vs IP (TP02 §6.3) → CV répétée et bootstrap (TP03 §4.8–4.9) → prédiction conforme (TP04 §7.4). Un seul chiffre de performance ne dit jamais tout : il faut aussi savoir à quel point il pourrait varier. |
Un point commun à toutes ces réponses : elles demandent de réserver des données qu’on s’interdit d’utiliser avant le bon moment (test, validation, calibration). C’est contraignant, mais c’est le prix d’une évaluation qu’on peut réellement croire.
Bilan de la progression TP02 → TP04 : d’un modèle unique évalué par split entraînement/test (TP02), à plusieurs modèles non-linéaires comparés par K-fold CV avec attention à l’incertitude d’échantillonnage (TP03), jusqu’à plusieurs modèles non-paramétriques sélectionnés sur un jeu de validation dédié et accompagnés d’une garantie de couverture par prédiction conforme (TP04) — la rigueur de l’évaluation augmente avec la flexibilité du modèle.
✅ Validation du TP¶
Ton notebook est terminé ! Il te reste à valider ce volet Python sur Moodle.
| Activité | Où ? |
|---|---|
| Questions CodeRunner du TP4 (à soumettre dans Moodle) | CodeRunner_TP4 (accès réservé aux étudiant·e·s UNIL) |
La page d’accueil du TP indique la section Évaluation et rendus (quiz théorique, questions CodeRunner, dépôts) : retour au TP4.
📝 Quiz Moodle¶
Une fois ce TP terminé, teste tes connaissances avec le quiz Moodle du TP4 :
👉 Ouvrir le quiz du TP4 sur Moodle (accès réservé aux étudiant·e·s UNIL)