TP Python 3 : Géotraitement vectoriel & modèles non-linéaires
Exécution dans le cloud : ce notebook peut aussi tourner dans le cloud (Colab, Kaggle, Renku). Avant de lancer les cellules, télécharge
tp3.gpkgetmeuse.csvdepuis le dossier OneDrive du cours et dépose-les dans le répertoire de travail du notebook (Colab : panneau 📁 → Upload ; Kaggle : File → Upload ; Renku : déjà dans le projet). Procédure complète : docs/cloud -badges .md.
TP Python 3 : Géotraitement vectoriel & modèles non-linéaires¶
Ce TP Python est le pendant numérique du TP QGIS 3. Tu vas reproduire les mêmes opérations de géotraitement vectoriel en Python, puis appliquer des modèles de régression non-linéaires sur des données géographiques historiques.
| Partie | Bibliothèque | Ce que tu apprendras |
|---|---|---|
| 1. Sélection & extraction | geopandas | Sélectionner des entités par attribut, dissoudre, découper |
| 2. Zones tampons | geopandas / shapely | Créer des buffers, définir la zone urbaine (ZDB, ZU) |
| 3. Superposition | geopandas / shapely | Union, différence, intersection → WUI |
| 4. GAM | statsmodels / sklearn | Modèles additifs généralisés, splines, lisseur spatial, validation croisée |
🔗 Lien avec le TP QGIS 3 : les parties 1–3 reproduisent en Python le même résultat que dans QGIS — la zone d’interface habitat-forêt (WUI) du district bernois de Frutigen-Niedersimmental. La partie 4 modélise la pollution des sols (jeu Meuse, Pays-Bas) : régression polynomiale, GLM et GAM avec lisseur spatial, pour prédire la concentration en zinc à partir de variables de terrain et de la position géographique.
Source
#@title Imports des bibliothèques
import os
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.colors as mcolors
from matplotlib.patches import Patch

import rasterio
from rasterio.transform import from_bounds
from rasterio.crs import CRS
from rasterio.features import rasterize

from scipy.ndimage import distance_transform_edt

import geopandas as gpd

from sklearn.linear_model import LogisticRegression, LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import (classification_report, confusion_matrix,
                             ConfusionMatrixDisplay, mean_absolute_error, r2_score)
Source
#@title Fonctions d'affichage (cartes et graphiques)
from matplotlib.patches import Patch
from matplotlib.lines import Line2D
from scipy.stats import pearsonr

# Style de chaque couche cartographique, selon son nom dans la légende
STYLES = {
    "Zone d'étude":         dict(facecolor='#f9f3e3', edgecolor='black', linewidth=1.5),
    'Forêt':                dict(color='#2e7d32', alpha=0.5),
    'Bâtiments':            dict(color='#c62828', alpha=0.8),
    'Routes':               dict(color='#616161', linewidth=0.4, alpha=0.6),
    'Communes':             dict(facecolor='none', edgecolor='#1565c0', linewidth=0.5, linestyle='--', alpha=0.5),
    'ZDB (±75 m)':          dict(facecolor='#ef9a9a', edgecolor='#c62828', linewidth=0.8, alpha=0.5),
    'Buffer routes (6 m)':  dict(facecolor='#b0bec5', edgecolor='none', alpha=0.6),
    'Zone Urbaine (ZU)':    dict(facecolor='#e57373', edgecolor='none', alpha=0.55),
    'Zone à risque (80 m)': dict(facecolor='#ffe082', edgecolor='none', alpha=0.45),
    'WUI':                  dict(facecolor='#ff6d00', edgecolor='none', alpha=0.85),
}


def nouvelle_figure(n=1, titre=None, taille=None):
    # Crée une figure de n graphiques côte à côte et renvoie leurs axes.
    if taille is None:
        taille = (min(7 * n, 16), 6 if n < 3 else 4.5)
    fig, axes = plt.subplots(1, n, figsize=taille, layout='constrained')
    if titre:
        fig.suptitle(titre, fontsize=13, fontweight='bold')
    return axes


def carte(couches, titre='', colonne=None, zoom=None, ax=None):
    # Superpose des couches (dictionnaire « nom dans la légende » → GeoDataFrame),
    # dans l'ordre du dictionnaire. colonne : colore les entités selon cette colonne.
    # zoom : demi-largeur (m) d'une fenêtre centrée sur la première couche.
    seule = ax is None
    if seule:
        ax = nouvelle_figure(taille=(12, 10))
    poignees = []
    for z, (nom, gdf) in enumerate(couches.items()):
        if colonne is not None:
            gdf.plot(ax=ax, column=colonne, cmap='Set2', edgecolor='black', linewidth=1.5,
                     alpha=0.7, legend=True, zorder=z)
            continue
        style = STYLES.get(nom, dict(alpha=0.6))
        gdf.plot(ax=ax, zorder=z, **style)
        if gdf.geom_type.str.contains('Line', na=False).any():
            poignees.append(Line2D([], [], color=style.get('color', 'k'), linewidth=2, label=nom))
        else:
            poignees.append(Patch(facecolor=style.get('facecolor', style.get('color', 'grey')),
                                  edgecolor=style.get('edgecolor', 'none'), alpha=style.get('alpha', 1),
                                  linestyle=style.get('linestyle', '-'), label=nom))
    if zoom is not None:
        x0, y0, x1, y1 = list(couches.values())[0].total_bounds
        cx, cy = (x0 + x1) / 2, (y0 + y1) / 2
        ax.set_xlim(cx - zoom, cx + zoom)
        ax.set_ylim(cy - zoom, cy + zoom)
    if poignees:
        ax.legend(handles=poignees, loc='upper right', fontsize=8)
    ax.set_title(titre, fontsize=11)
    ax.set_xlabel('Est (m)')
    ax.set_ylabel('Nord (m)')
    if seule:
        plt.show()


def carte_points(x, y, valeurs, titre='', legende='', limite=None, ax=None):
    # Carte de points colorés selon valeurs. Avec limite, échelle divergente
    # centrée sur 0, de -limite à +limite (pour des résidus).
    seule = ax is None
    if seule:
        ax = nouvelle_figure()
    if limite is None:
        sc = ax.scatter(x, y, c=valeurs, cmap='YlOrRd', s=45, edgecolor='k', linewidth=0.3)
    else:
        sc = ax.scatter(x, y, c=valeurs, cmap='PiYG', vmin=-limite, vmax=limite, s=40,
                        edgecolor='k', linewidth=0.2)
    plt.colorbar(sc, ax=ax, label=legende, shrink=0.8)
    ax.set_title(titre, fontsize=11)
    ax.set_xlabel('x (m, RD New)')
    ax.set_ylabel('y (m, RD New)')
    ax.set_aspect('equal')
    ax.xaxis.set_major_locator(plt.MaxNLocator(4))   # graduations lisibles
    if seule:
        plt.show()


def matrice_correlation(corr, noms, ax=None):
    # Matrice de corrélation (tableau carré), avec la valeur écrite dans chaque case.
    seule = ax is None
    if seule:
        ax = nouvelle_figure()
    im = ax.imshow(corr, cmap='RdBu', vmin=-1, vmax=1)
    ax.set_xticks(range(len(noms)), noms, rotation=45, ha='right')
    ax.set_yticks(range(len(noms)), noms)
    for i in range(len(noms)):
        for j in range(len(noms)):
            v = corr.iloc[i, j]
            ax.text(j, i, f"{v:.2f}", ha='center', va='center', fontsize=9,
                    color='white' if abs(v) > 0.5 else 'black')
    plt.colorbar(im, ax=ax, shrink=0.7, label='Corrélation de Pearson')
    ax.set_title('Matrice de corrélation', fontsize=11)
    if seule:
        plt.show()


def nuage(x, y, xlabel='', ylabel='', droite=False, ax=None):
    # Nuage de points de y en fonction de x. Avec droite=True : droite de régression,
    # et coefficient de corrélation r dans le titre.
    seule = ax is None
    if seule:
        ax = nouvelle_figure()
    ax.scatter(x, y, s=20, alpha=0.6, color='steelblue')
    if droite:
        m, b = np.polyfit(x, y, 1)
        xs = np.sort(x)
        ax.plot(xs, m * xs + b, color='crimson', linewidth=2)
        ax.set_title(f'r = {pearsonr(x, y)[0]:.2f}')
    ax.set_xlabel(xlabel.replace('\n', ' '))
    ax.set_ylabel(ylabel)
    if seule:
        plt.show()


def graphique_polynomes(x_tr, y_tr, x_te, y_te, degres, xlabel='', ylabel='', titre=''):
    # Points d'entraînement (noirs) et jamais vus (gris), et polynômes ajustés sur l'entraînement.
    ax = nouvelle_figure(taille=(9, 6))
    ax.scatter(x_te, y_te, alpha=0.3, s=20, color='grey', label='Reste des sites (jamais vus)')
    ax.scatter(x_tr, y_tr, s=40, color='black', zorder=5, label=f"Échantillon d'entraînement (n={len(x_tr)})")
    x_line = np.linspace(min(x_tr.min(), x_te.min()), max(x_tr.max(), x_te.max()), 300)
    for deg, couleur in zip(degres, ['crimson', 'seagreen', 'orange', 'purple']):
        coeffs = np.polyfit(x_tr, y_tr, deg)
        ax.plot(x_line, np.polyval(coeffs, x_line), color=couleur, linewidth=2, label=f'Degré {deg}')
    y_tous = np.concatenate([y_tr, y_te])
    ax.set_ylim(y_tous.min() - 100, y_tous.max() + 150)   # les oscillations des degrés élevés sortent du cadre
    ax.set_xlabel(xlabel)
    ax.set_ylabel(ylabel)
    ax.set_title(titre)
    ax.legend(fontsize=9)
    plt.show()


def effets_partiels(gam, variables, noms, titre=''):
    # Un graphique par variable : effet partiel f(variable) estimé par le GAM,
    # avec son intervalle de confiance.
    axes = nouvelle_figure(len(variables), titre)
    for i, (ax, var, nom) in enumerate(zip(axes, variables, noms)):
        gam.plot_partial(i, ax=ax, plot_se=True)
        ax.axhline(0, color='k', linewidth=0.8, linestyle='--')
        ax.set_xlabel(nom.replace('\n', ' '))
        ax.set_ylabel('Effet partiel sur le zinc')
        ax.set_title(f'f({var})')
    plt.show()


def boites(series, ylabel='', titre=''):
    # Boîtes à moustaches : une boîte par série de valeurs (dictionnaire nom → valeurs).
    ax = nouvelle_figure(taille=(8, 5))
    ax.boxplot(list(series.values()), tick_labels=list(series.keys()))
    ax.axhline(0, color='grey', linewidth=0.8, linestyle='--')
    ax.set_ylabel(ylabel)
    ax.set_title(titre)
    plt.show()


def histogramme(valeurs, xlabel='', ylabel='', titre='', intervalle=None):
    # Histogramme des valeurs, avec leur moyenne et, si fourni, les bornes d'un
    # intervalle de confiance à 95 % (tirets).
    ax = nouvelle_figure(taille=(8, 5))
    ax.hist(valeurs, bins=30, color='#42a5f5', alpha=0.85, edgecolor='white')
    if intervalle is not None:
        bas, haut = intervalle
        ax.axvline(bas, color='crimson', linestyle='--', linewidth=2)
        ax.axvline(haut, color='crimson', linestyle='--', linewidth=2,
                   label=f'IC 95 % : [{bas:.3f}, {haut:.3f}]')
    ax.axvline(np.mean(valeurs), color='black', linewidth=1.5, label=f'Moyenne = {np.mean(valeurs):.3f}')
    ax.set_xlabel(xlabel)
    ax.set_ylabel(ylabel)
    ax.set_title(titre)
    ax.legend(fontsize=9)
plt.show()# -------------------------------------------------------
# Chemins d'accès aux données : adapte-les si nécessaire
# -------------------------------------------------------
DATA_PATH = 'tp3.gpkg'
MEUSE_PATH = 'meuse.csv'Source
#@title Chargement des données vectorielles (tp3.gpkg)
CRS_REF   = 'EPSG:21781'   # CH1903 / LV03

foret     = gpd.read_file(DATA_PATH, layer='Foret').to_crs(CRS_REF)
buildings = gpd.read_file(DATA_PATH, layer='Buildings').to_crs(CRS_REF)
roads     = gpd.read_file(DATA_PATH, layer='Roads').to_crs(CRS_REF)
communes  = gpd.read_file(DATA_PATH, layer='Communes').to_crs(CRS_REF)
districts = gpd.read_file(DATA_PATH, layer='districts').to_crs(CRS_REF)

print("Couches vectorielles chargées depuis tp3.gpkg :")
for name, gdf in [
    ('Foret',     foret),
    ('Buildings', buildings),
    ('Roads',     roads),
    ('Communes',  communes),
    ('Districts', districts),
]:
    geom_type = gdf.geometry.geom_type.iloc[0]
    print(f"  {name:12s}: {len(gdf):7d} entités | CRS: EPSG:{gdf.crs.to_epsg()} | géométrie: {geom_type}")
Couches vectorielles chargées depuis tp3.gpkg :
Foret : 13461 entités | CRS: EPSG:21781 | géométrie: MultiPolygon
Buildings : 373399 entités | CRS: EPSG:21781 | géométrie: MultiPolygon
Roads : 112567 entités | CRS: EPSG:21781 | géométrie: MultiLineString
Communes : 8868 entités | CRS: EPSG:21781 | géométrie: MultiPolygon
Districts : 234 entités | CRS: EPSG:21781 | géométrie: MultiPolygon
Remplacer des valeurs avec .map()
La couche districts ne couvre pas seulement la Suisse : la colonne ICC contient le code du pays de chaque
district (CH, AT, DE, FR, IT). Pour rendre ces codes lisibles, on peut les remplacer par le nom du pays
à l’aide d’un dictionnaire et de la méthode
serie.map(dictionnaire) :
le dictionnaire associe à chaque clé (ici, un code de pays) une valeur (ici, le nom du pays) ;
pour chaque ligne de la colonne,
.map()cherche la clé correspondante dans le dictionnaire et la remplace par la valeur associée ;le résultat est une nouvelle colonne, de même longueur que la colonne de départ. Une valeur absente du dictionnaire devient
NaN(valeur manquante).
Au TP2 (section 6.7), .map() recevait une fonction plutôt qu’un dictionnaire : le principe est le même, chaque
valeur de la colonne est transformée une à une.
# Dictionnaire : code du pays (clé) → nom du pays (valeur)
pays = {'CH': 'Suisse', 'AT': 'Autriche', 'DE': 'Allemagne', 'FR': 'France', 'IT': 'Italie'}

districts['PAYS'] = districts['ICC'].map(pays)
print(districts[['NAME', 'ICC', 'PAYS']].head())
print("\nNombre d'entités par pays :")
print(districts['PAYS'].value_counts().to_string())
NAME ICC PAYS
0 Engiadina Bassa/Val Müstair CH Suisse
1 Albula CH Suisse
2 Imst AT Autriche
3 Entremont CH Suisse
4 Prättigau/Davos CH Suisse
Nombre d'entités par pays :
PAYS
Suisse 169
Italie 27
France 19
Autriche 11
Allemagne 8
Partie 1 — Sélection et extraction¶
Dans le TP QGIS 3, nous avons commencé par sélectionner les districts bernois de Frutigen-Niedersimmental et Obersimmental-Saanen, les avons fusionnés pour définir le périmètre d’étude, puis avons découpé les autres couches dans ce périmètre.
En Python avec geopandas, les équivalents sont :
| Outil QGIS | Équivalent Python |
|---|---|
| Sélection par expression | gdf[gdf['col'].str.contains(...)] |
| Fusionner les entités | gdf.dissolve() |
| Couper (Clip) | gpd.clip(layer, mask) |
1.1 Sélection des districts et fusion (étapes 2a/2b)¶
On sélectionne les districts par expression (équivalent du filtre SQL "NAME" ILIKE '...'
dans QGIS), puis on les fusionne en une seule entité (dissolve) pour
définir le périmètre global de la zone d’étude.
Exercice 1 : sélectionner et fusionner les districts
Complète la cellule à trous ci-dessous pour sélectionner les deux districts de la zone d’étude, Frutigen-Niedersimmental et Obersimmental-Saanen, puis pour les fusionner en une seule entité study_area.
Pour cela, tu peux utiliser :
serie.str.contains(motif)teste, pour chaque ligne d’une colonne de texte, si elle contientmotif. Elle renvoie une série deTrue/False, qui sert de filtre entre crochets :gdf[gdf['col'].str.contains('Lausanne')]ne garde que les lignes dont la colonnecolcontient « Lausanne ». Tu as déjà rencontré cette méthode au TP2, dans une requête.query()(section 2.4).Le motif de
str.containsest une expression régulière, dans laquelle|signifie « ou » :'Lausanne|Morges'garde les lignes qui contiennent l’un ou l’autre nom. Enfin,case=Falseignore les majuscules etna=Falseécarte les valeurs manquantes.gdf.dissolve()fusionne les entités d’un GeoDataFrame, comme l’outil Regrouper de QGIS. Avec l’argumentby='colonne', elle fusionne les entités qui partagent la même valeur dans cette colonne ; sans argument, elle fusionne toutes les entités en une seule.
# Cellule libre : explore ici la couche districts,
# par exemple avec districts['NAME'].unique() pour afficher la liste des noms
# 2a — Sélection par expression (= filtre SQL dans QGIS)
study_districts = districts[
districts['NAME'].str.contains(____, case=False, na=False)
].copy()
# 2b — Fusionner les entités (= dissolve / Fusionner dans QGIS)
study_area = ____Source
#@title Une solution possible (exercice 1)
study_districts = districts[
    districts['NAME'].str.contains(
        'Frutigen-Niedersimmental|Obersimmental-Saanen',
        case=False, na=False
    )
].copy()
# reset_index(drop=True)[['geometry']] ne conserve que la géométrie fusionnée
study_area = study_districts.dissolve().reset_index(drop=True)[['geometry']]
print(f"Districts sélectionnés ({len(study_districts)}) :")
for _, row in study_districts.iterrows():
print(f" • {row['NAME']}")
print(f"\nZone d'étude fusionnée : 1 polygone")
print(f" Aire totale : {study_area.geometry.area.iloc[0] / 1e6:.1f} km²")
print(f" Périmètre : {study_area.geometry.length.iloc[0] / 1e3:.1f} km")Districts sélectionnés (2) :
• Frutigen-Niedersimmental
• Obersimmental-Saanen
Zone d'étude fusionnée : 1 polygone
Aire totale : 1349.1 km²
Périmètre : 205.5 km
# nouvelle_figure() et carte() sont des fonctions d'affichage définies dans une cellule masquée, au début du notebook
ax1, ax2 = nouvelle_figure(2, 'Sélection et fusion des districts (TP3 — étapes 2a/2b)')
carte({'Districts sélectionnés': study_districts}, colonne='NAME',
      titre='Districts sélectionnés\n(sélection par expression)', ax=ax1)
carte({"Zone d'étude": study_area}, titre="Zone d'étude fusionnée\n(dissolve — étape 2b)", ax=ax2)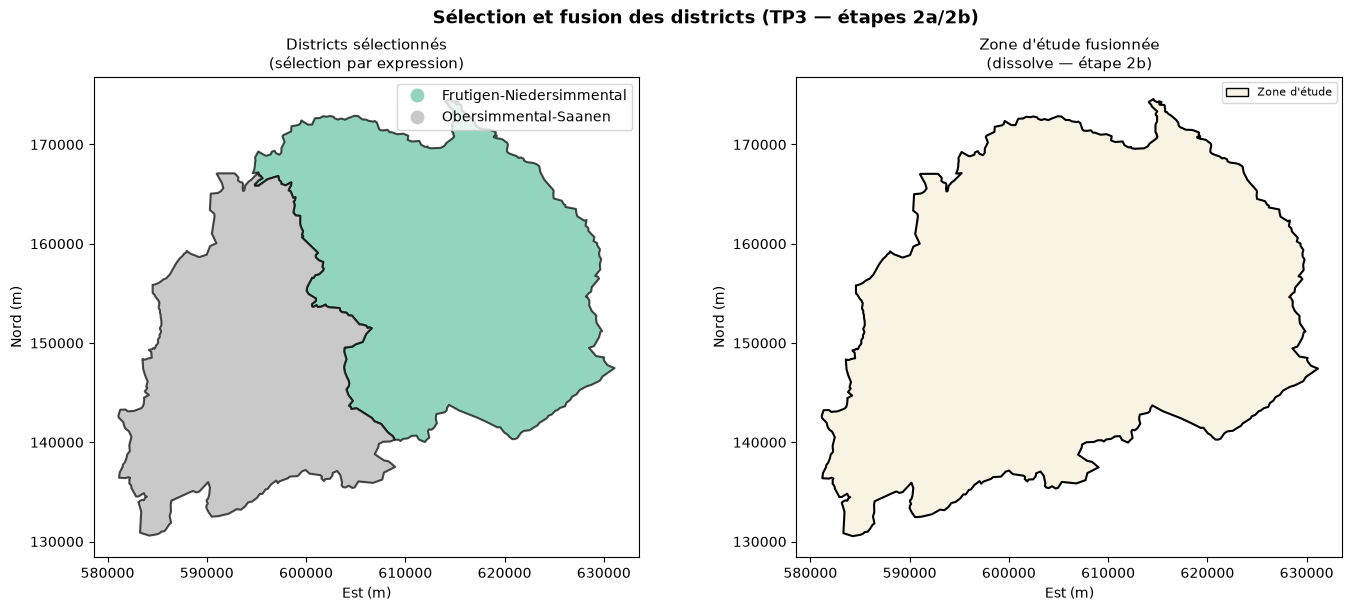
1.2 Découpage des couches (étape 2c)¶
Une fois le périmètre défini, on découpe toutes les couches avec gpd.clip(),
l’équivalent de l’outil Couper (Clip) dans QGIS.
Cela garantit que les géotraitements suivants ne portent que sur la zone d’étude.
# -------------------------------------------------------
# 2c — Découpage (= outil Clip dans QGIS)
# -------------------------------------------------------
print("Découpage des couches à la zone d'étude...")

foret_clip     = gpd.clip(foret,     study_area).reset_index(drop=True)
buildings_clip = gpd.clip(buildings, study_area).reset_index(drop=True)
roads_clip     = gpd.clip(roads,     study_area).reset_index(drop=True)
communes_clip  = gpd.clip(communes,  study_area).reset_index(drop=True)

print("\nRésultat du découpage :")
for name, gdf in [
    ('Forêt',      foret_clip),
    ('Bâtiments',  buildings_clip),
    ('Routes',     roads_clip),
    ('Communes',   communes_clip),
]:
    print(f"  {name:12s}: {len(gdf):6d} entités")
Découpage des couches à la zone d'étude...
Résultat du découpage :
  Forêt       :    409 entités
  Bâtiments   :   2680 entités
  Routes      :    806 entités
  Communes    :     48 entités
# Carte de base découpée (étape 2d dans QGIS) : les couches sont superposées dans l'ordre du dictionnaire
carte({"Zone d'étude": study_area, 'Forêt': foret_clip, 'Bâtiments': buildings_clip,
       'Routes': roads_clip, 'Communes': communes_clip},
      titre="Carte de base — couches découpées à la zone d'étude (étape 2d)")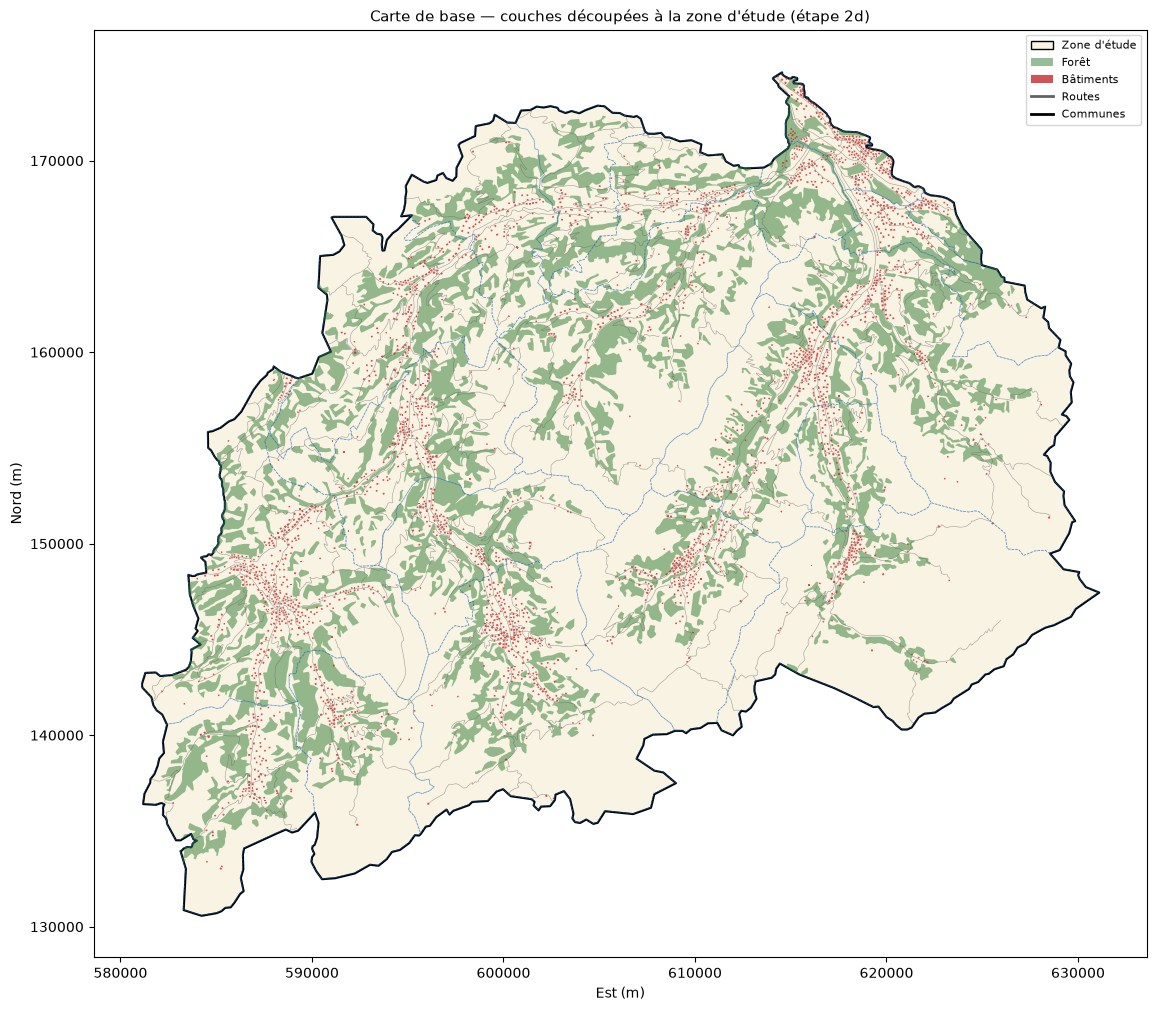
Partie 2 — Zones tampons (Buffer)¶
Les zones tampons permettent de définir des zones de proximité autour d’entités. Dans QGIS, nous avons utilisé l’outil Zone tampon pour :
Zone Densément Bâtie (ZDB) — buffer
+75 msur les bâtiments (regroupé), puis buffer−75 mpour conserver uniquement les zones densément bâtiesEmprise des routes — buffer de
6 m(= moitié de la largeur de 12 m)
| Outil QGIS | Équivalent Python |
|---|---|
| Zone tampon (Buffer) | .buffer(distance) sur geometry |
| Regrouper le résultat | .union_all() (fusionne en une seule géométrie) |
2.1 ZDB — Zone Densément Bâtie (étape 3a)¶
# -------------------------------------------------------
# 3a — Zone Densément Bâtie (ZDB)
#   Étape 1 : buffer +75 m sur les bâtiments, regroupé
#   Étape 2 : buffer −75 m pour éliminer les zones peu denses
# -------------------------------------------------------
print("Étape 1 : buffer +75 m sur les bâtiments (regroupé)...")
buf_pos = buildings_clip.geometry.buffer(75).union_all()   # buffer + regroupement

print("Étape 2 : buffer −75 m pour garder uniquement les zones denses (ZDB)...")
zdb_geom = buf_pos.buffer(-75)
zdb = gpd.GeoDataFrame(geometry=[zdb_geom], crs=CRS_REF)
print(f"  ZDB : aire totale = {zdb_geom.area / 1e6:.2f} km²")

# -------------------------------------------------------
# 3b — Buffer routes (6 m = moitié de la largeur totale de 12 m)
# -------------------------------------------------------
print("\nBuffer routes (6 m)...")
roads_buf_geom = roads_clip.geometry.buffer(6).union_all()
roads_buf = gpd.GeoDataFrame(geometry=[roads_buf_geom], crs=CRS_REF)
print(f"  Routes bufferisées : aire = {roads_buf_geom.area / 1e6:.2f} km²")
Étape 1 : buffer +75 m sur les bâtiments (regroupé)...
Étape 2 : buffer −75 m pour garder uniquement les zones denses (ZDB)...
  ZDB : aire totale = 32.30 km²

Buffer routes (6 m)...
Routes bufferisées : aire = 15.05 km²
ax1, ax2 = nouvelle_figure(2, 'Zones tampons — étapes 3a et 3b')
carte({"Zone d'étude": study_area, 'Bâtiments': buildings_clip, 'ZDB (±75 m)': zdb},
      titre='Zone Densément Bâtie (ZDB)\nbuffer +75 m puis −75 m', ax=ax1)
carte({"Zone d'étude": study_area, 'Routes': roads_clip, 'Buffer routes (6 m)': roads_buf},
      titre='Buffer sur les routes (6 m)\n(moitié de la largeur)', ax=ax2)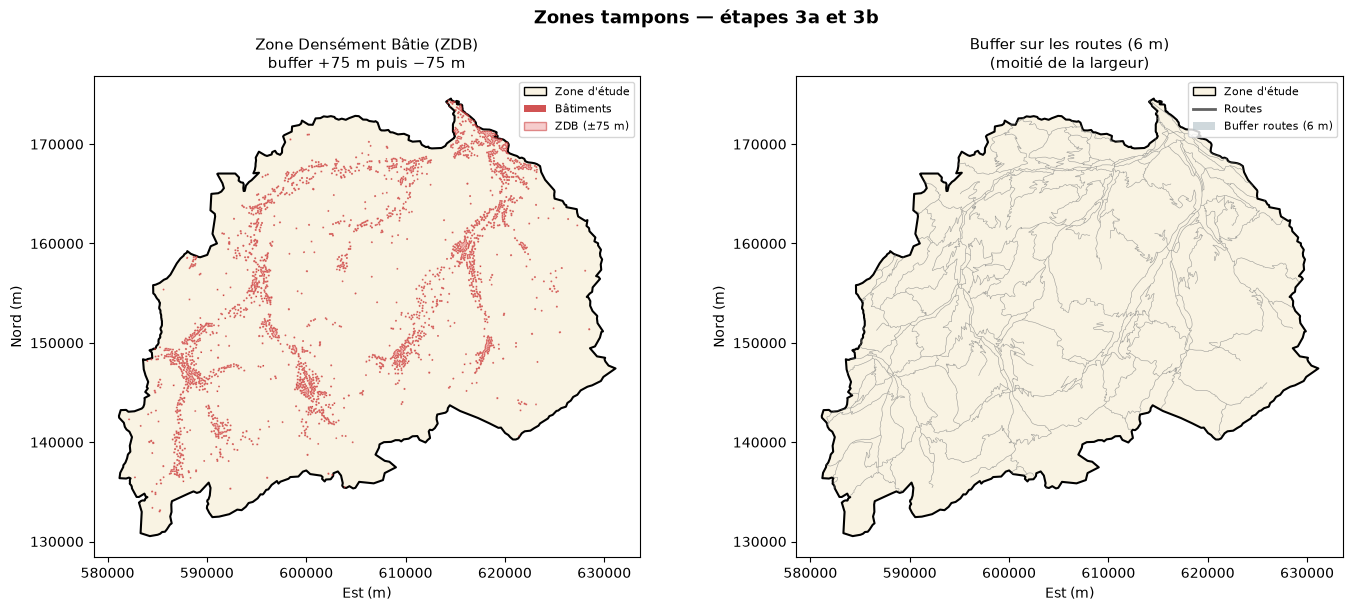
Exercice 2 : effet de la distance de regroupement
La ZDB dépend de la distance choisie : avec 75 m, deux bâtiments distants de moins de 150 m sont regroupés. Recalcule la ZDB avec une autre distance d, en enchaînant sur une seule ligne les deux zones tampons de l’étape 3a (+d regroupée, puis −d). Essaie plusieurs valeurs, par exemple 10, 25, 150 et 300 m : comment évoluent la surface de la ZDB et le nombre de groupes de bâtiments ? Pourquoi ?
Pour cela, tu peux utiliser :
geom.buffer(distance)renvoie la zone tampon d’une géométrie, ou de chaque géométrie d’une GeoSeries. La distance s’exprime dans l’unité du système de coordonnées, ici le mètre. Une distance négative rétrécit la géométrie au lieu de l’agrandir.serie.union_all()regroupe toutes les géométries d’une GeoSeries en une seule géométrie, comme l’option Dissoudre le résultat de l’outil Zone tampon dans QGIS.Le chaînage de méthodes : chaque méthode s’applique au résultat de la précédente, de gauche à droite. Ainsi,
a.methode1(x).methode2(y)appliquemethode1àa, puismethode2au résultat obtenu.
d        = ____   # distance de regroupement, en m
zdb_test = ____   # zone tampon de +d regroupée, puis de −d

print(f"d = {d} m : ZDB = {zdb_test.area / 1e6:.2f} km² en {len(gpd.GeoSeries([zdb_test]).explode())} groupes de bâtiments")
print(f"Référence d = 75 m : ZDB = {zdb_geom.area / 1e6:.2f} km²")
Source
#@title Une solution possible (exercice 2)
d = 150
zdb_test = buildings_clip.geometry.buffer(d).union_all().buffer(-d)

print(f"d = {d} m : ZDB = {zdb_test.area / 1e6:.2f} km² en {len(gpd.GeoSeries([zdb_test]).explode())} groupes de bâtiments")
print(f"Référence d = 75 m : ZDB = {zdb_geom.area / 1e6:.2f} km²")

# Plus d est grand, plus des bâtiments éloignés les uns des autres (jusqu'à 2 × d) sont reliés :
# les groupes fusionnent, leur nombre diminue et la ZDB s'étend. Avec une petite distance (10 m),
# la ZDB se réduit presque à l'emprise des bâtiments eux-mêmes.
d = 150 m : ZDB = 59.09 km² en 588 groupes de bâtiments
Référence d = 75 m : ZDB = 32.30 km²
Partie 3 — Superposition (Union, Différence, Intersection)¶
Ces outils permettent de combiner plusieurs couches pour créer de nouvelles entités. C’est l’étape centrale du TP pour produire la WUI (Wildland-Urban Interface).
| Outil QGIS | Équivalent Python (shapely) |
|---|---|
| Union | geom_a.union(geom_b) |
| Différence | geom_a.difference(geom_b) |
| Intersection | geom_a.intersection(geom_b) |
3.1 Zone Urbaine (ZU) = ZDB ∪ routes (étape 4a)¶
3.2 Zone à risque = Buffer(ZU, 80 m) − ZU (étape 4b)¶
3.3 WUI = zone à risque ∩ Forêt (étape 4c)¶
Exercice 3 : construire la WUI
Traduis en code les trois opérations des titres 3.1 à 3.3 ci-dessus. Les géométries de départ sont zdb_geom (ZDB), roads_buf_geom (routes bufferisées) et foret_union (forêt regroupée). Une fois la carte finale affichée, compare-la avec ta couche WUI du TP QGIS.
Pour cela, tu peux utiliser les opérations de superposition de shapely. Elles s’appliquent à une géométrie a, prennent une autre géométrie b en argument, et renvoient une nouvelle géométrie, que tu peux stocker dans une variable pour l’utiliser à l’étape suivante :
a.union(b)renvoie la surface couverte paraou parb(a ∪ b).a.difference(b)renvoie la partie deaqui n’est pas dansb(a − b). L’ordre compte :b.difference(a)donne un tout autre résultat.a.intersection(b)renvoie la partie commune àaet àb(a ∩ b).a.buffer(distance)renvoie la zone tampon dea, comme en partie 2.
foret_union = foret_clip.geometry.union_all()   # forêt regroupée en une seule géométrie

# 4a — Zone Urbaine (ZU) = ZDB ∪ routes bufferisées
zu_geom = ____

# 4b — Zone à risque = Buffer(ZU, 80 m) − ZU
zu_buf_80 = ____
zone_risque_geom = ____

# 4c — WUI = zone à risque ∩ Forêt
wui_geom = ____

print(f"WUI : aire = {wui_geom.area / 1e6:.2f} km²")
Source
#@title Une solution possible (exercice 3)
foret_union = foret_clip.geometry.union_all()   # forêt regroupée en une seule géométrie

# 4a — Zone Urbaine (ZU) = ZDB ∪ routes bufferisées
zu_geom = zdb_geom.union(roads_buf_geom)

# 4b — Zone à risque = Buffer(ZU, 80 m) − ZU
zu_buf_80 = zu_geom.buffer(80)
zone_risque_geom = zu_buf_80.difference(zu_geom)

# 4c — WUI = zone à risque ∩ Forêt
wui_geom = zone_risque_geom.intersection(foret_union)

print(f"WUI : aire = {wui_geom.area / 1e6:.2f} km²")
WUI : aire = 46.21 km²
zu = gpd.GeoDataFrame(geometry=[zu_geom], crs=CRS_REF)
zone_risque = gpd.GeoDataFrame(geometry=[zone_risque_geom], crs=CRS_REF)
wui = gpd.GeoDataFrame(geometry=[wui_geom], crs=CRS_REF)

print(f"  Zone Urbaine (ZU) : aire = {zu_geom.area / 1e6:.2f} km²")
print(f"  Zone à risque (bande 80 m hors ZU) : aire = {zone_risque_geom.area / 1e6:.2f} km²")
print(f"  WUI : aire = {wui_geom.area / 1e6:.2f} km²")
print(f"  WUI représente {wui_geom.area / foret_union.area * 100:.1f} % de la surface forestière")
Zone Urbaine (ZU) : aire = 46.66 km²
Zone à risque (bande 80 m hors ZU) : aire = 233.50 km²
WUI : aire = 46.21 km²
WUI représente 15.5 % de la surface forestière
# Carte finale — WUI (vue d'ensemble + zoom de 2 × 8 km au centre pour mieux voir la WUI)
couches = {"Zone d'étude": study_area, 'Forêt': foret_clip, 'Zone Urbaine (ZU)': zu,
           'Zone à risque (80 m)': zone_risque, 'WUI': wui}

ax1, ax2 = nouvelle_figure(2, 'Wildland-Urban Interface (WUI) — Frutigen-Niedersimmental')
carte(couches, titre="WUI — vue d'ensemble", ax=ax1)
carte(couches, titre='WUI — zoom zone centrale', zoom=8000, ax=ax2)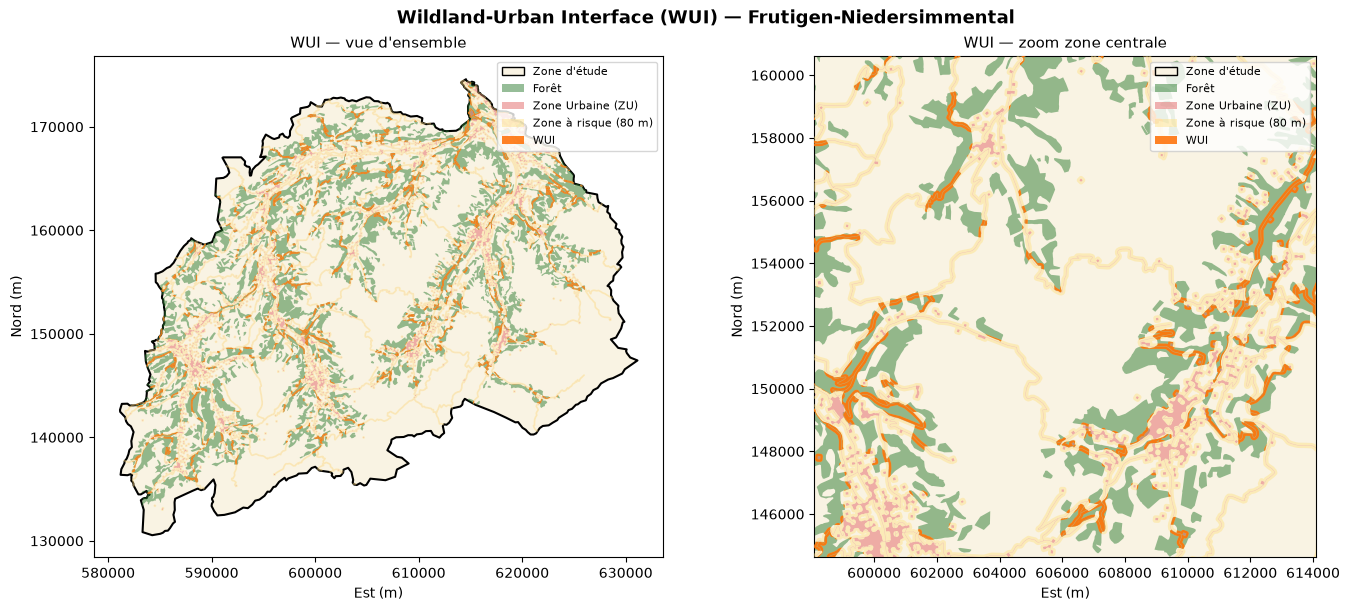
Partie 4 — Régression non-linéaire : polynômes, GLM et GAM¶
Pourquoi aller au-delà de la régression linéaire ?¶
La régression linéaire (OLS) suppose que l’effet de chaque variable explicative est constant et proportionnel, et que la variable cible peut prendre n’importe quelle valeur réelle. Ces deux hypothèses sont souvent trop restrictives pour des données réelles, en particulier géographiques : l’effet d’une variable peut se courber (s’atténuer, s’inverser), et une variable physiquement bornée (une concentration, un pourcentage, un compte) ne se prête pas à une droite qui peut, en théorie, prendre n’importe quelle valeur.
Cette partie relâche ces hypothèses progressivement, en gardant le même jeu de données (Meuse) et la même variable cible (zinc) comme fil conducteur :
| Étape | Ce qui change par rapport à OLS | Section |
|---|---|---|
| Régression polynomiale | La relation n’est plus une droite mais un polynôme, reste un modèle linéaire dans ses paramètres | 4.3 |
| GLM (Generalized Linear Model) | La prédiction est transformée (via un logarithme) pour rester dans une plage valide, ici | 4.4 |
| GAM (Generalized Additive Model) | Chaque effet devient une fonction lisse apprise depuis les données, sans forme paramétrique imposée | 4.5–4.6 |
Ces fonctions lisses (GAM) sont approximées par des B-splines (polynômes par morceaux raccordés) avec une pénalité de lissage pour éviter le surapprentissage.
Les données : la Meuse (pollution des sols, Pays-Bas)¶
Le jeu Meuse est un classique de la géostatistique : 155 sites de sol échantillonnés dans la plaine inondable de la rivière Meuse, près de Stein (Pays-Bas). Deux sites n’ont pas de mesure de matière organique et sont écartés : 153 sites sont utilisés pour la modélisation. Les crues déposent des sédiments chargés en métaux lourds ; on mesure notamment la concentration en zinc.
| Variable | Description |
|---|---|
| zinc | Concentration en zinc dans le sol (ppm) ← variable cible |
| dist | Distance à la rivière (normalisée 0–1) |
| elev | Altitude relative du site (m) |
| om | Matière organique du sol (%) |
| x, y | Coordonnées du site (CRS RD New, EPSG:28992) |
Question : peut-on expliquer la concentration en zinc à partir de ces variables de terrain ? La position géographique (proximité de la rivière, effet des crues) joue-t-elle un rôle propre, au-delà des variables mesurées ?
Source
#@title Imports et chargement des données Meuse
from statsmodels.gam.api import GLMGam, BSplines
import statsmodels.formula.api as smf
import statsmodels.api as sm
from sklearn.preprocessing import SplineTransformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import Ridge
from sklearn.model_selection import KFold, cross_val_score
import pandas as pd
import warnings
warnings.filterwarnings('ignore', category=FutureWarning)   # ciblé : pas de masquage global

# La Meuse : 155 sites de sol. On charge le CSV et on reconstruit un GeoDataFrame
# (points), avec le système de coordonnées néerlandais RD New (EPSG:28992).
meuse = pd.read_csv(MEUSE_PATH)
meuse = gpd.GeoDataFrame(
    meuse,
    geometry=gpd.points_from_xy(meuse['x'], meuse['y']),
    crs='EPSG:28992',
)

target   = 'zinc'
features = ['dist', 'elev', 'om']
labels   = ['Distance\nrivière', 'Altitude', 'Matière\norganique']

# 2 sites n'ont pas de mesure de matière organique (om). On ne garde que les
# sites aux mesures complètes pour la modélisation (analyse en cas complets).
meuse = meuse.dropna(subset=[target] + features).reset_index(drop=True)

y    = meuse[target].values
X_th = meuse[features].values
X_sp = meuse[features + ['x', 'y']].values

print(f"Meuse : {len(meuse)} sites aux mesures complètes | CRS : {meuse.crs}\n")
print(meuse[[target] + features].describe().round(2).to_string())
Meuse : 153 sites aux mesures complètes | CRS : EPSG:28992
zinc dist elev om
count 153.00 153.00 153.00 153.00
mean 473.61 0.24 8.16 7.48
std 367.87 0.20 1.06 3.43
min 113.00 0.00 5.18 1.00
25% 198.00 0.08 7.54 5.30
50% 332.00 0.21 8.18 6.90
75% 676.00 0.36 8.97 9.00
max 1839.00 0.88 10.52 17.00
4.1 Exploration : carte et corrélations¶
Avant de modéliser, on visualise la distribution spatiale du zinc et les corrélations entre variables. La carte révèle d’emblée un fort gradient géographique, les concentrations les plus élevées longent la rivière, qui motivera plus loin l’ajout d’un lisseur spatial.
# Carte des sites colorés selon le zinc, et matrice de corrélation entre le zinc et les variables de terrain
ax1, ax2 = nouvelle_figure(2, 'Exploration du jeu de données Meuse — 153 sites')
carte_points(meuse['x'], meuse['y'], meuse['zinc'], legende='Zinc (ppm)',
             titre='Concentration de zinc dans le sol\nplaine de la Meuse (153 sites)', ax=ax1)
matrice_correlation(meuse[[target] + features].corr(),
                    noms=['Zinc', 'Dist. rivière', 'Altitude', 'Mat. org.'], ax=ax2)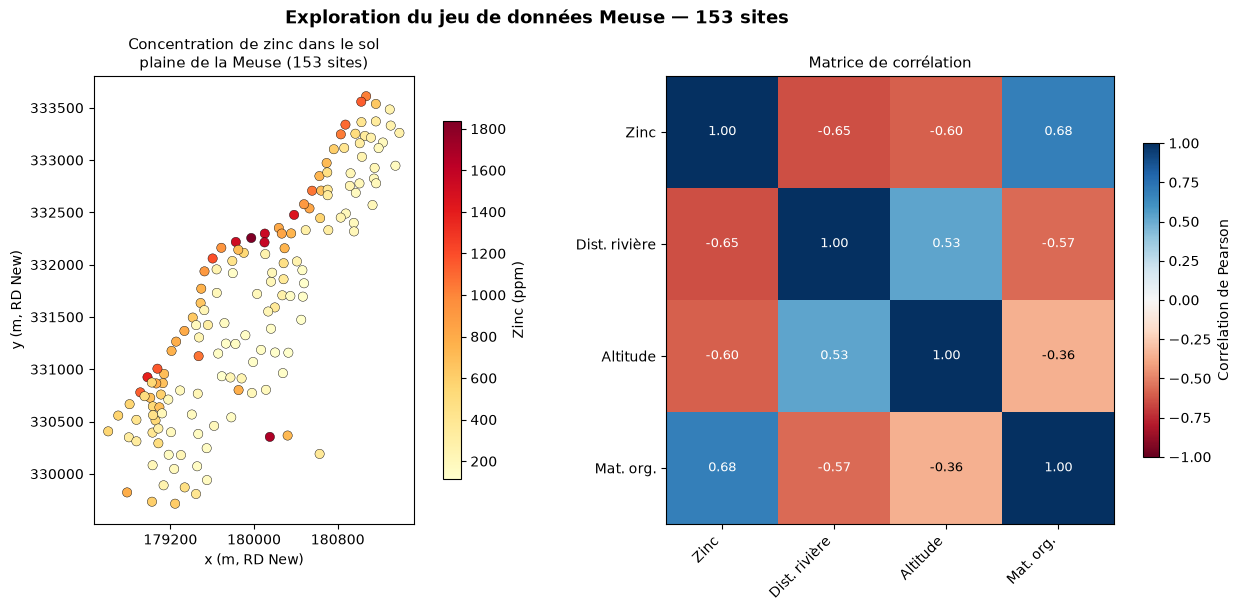
4.2 Référence : régression linéaire (OLS)¶
On commence par un modèle de référence — la régression linéaire multiple OLS — qui suppose une relation linéaire entre chaque variable explicative et le zinc. Son R² sera la baseline à améliorer.
ols = smf.ols('zinc ~ dist + elev + om', data=meuse).fit()
print(f"OLS — R² = {ols.rsquared:.3f}  |  R² adj. = {ols.rsquared_adj:.3f}\n")
print(ols.summary().tables[1])
OLS — R² = 0.640 | R² adj. = 0.632
==============================================================================
coef std err t P>|t| [0.025 0.975]
------------------------------------------------------------------------------
Intercept 1119.9189 170.020 6.587 0.000 783.957 1455.881
dist -419.5711 122.073 -3.437 0.001 -660.788 -178.354
elev -110.2440 20.113 -5.481 0.000 -149.988 -70.500
om 47.3627 6.416 7.382 0.000 34.685 60.041
==============================================================================
# Un nuage de points par variable de terrain, avec la droite de régression et le coefficient r
axes = nouvelle_figure(3, f"OLS — nuages de points (R² = {ols.rsquared:.3f})")
for ax, feat, label in zip(axes, features, labels):
    nuage(meuse[feat], meuse['zinc'], xlabel=label, ylabel='Zinc (ppm)', droite=True, ax=ax)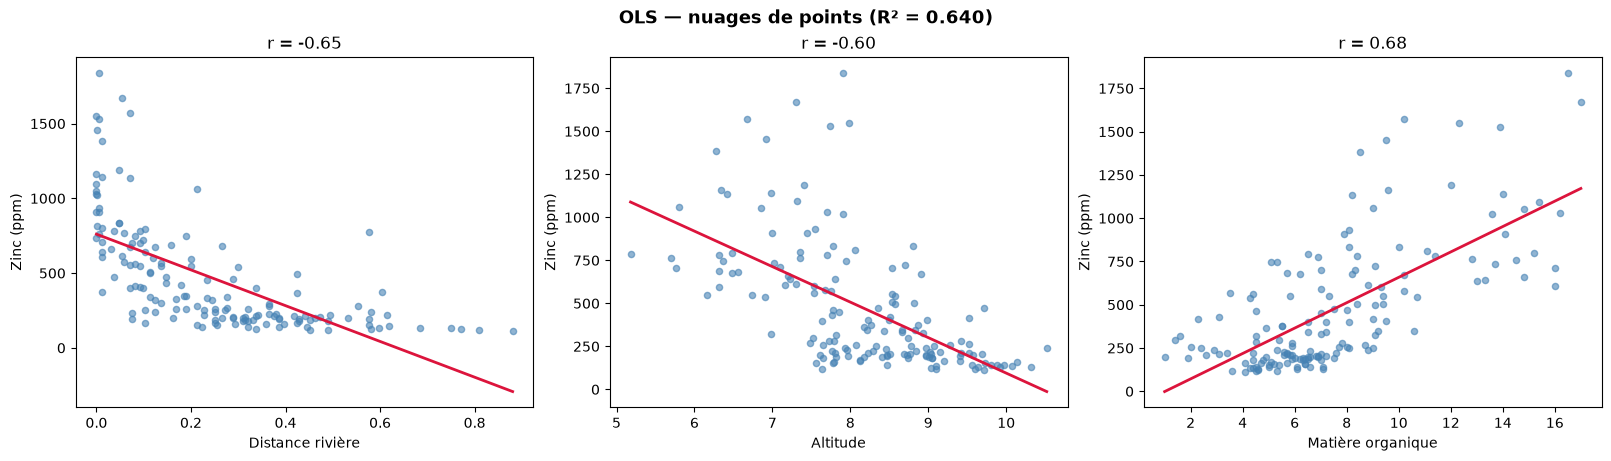
4.3 Régression polynomiale¶
La régression polynomiale remplace la droite par un polynôme
Malgré son nom, c’est toujours un modèle linéaire au sens statistique : linéaire par rapport aux paramètres (on l’ajuste avec np.polyfit, ou une régression OLS sur les colonnes ). Seule la relation entre et devient non-linéaire.
Le degré contrôle la flexibilité. Ici, la relation zinc ~ dist est réellement courbée : le zinc décroît vite près de la rivière puis se stabilise (décroissance de type distance-décroissance). C’est le cas idéal pour voir les deux faces du polynôme :
une droite (degré 1) sous-ajuste — elle rate la courbure et laisse une structure nette dans les résidus ;
un polynôme de degré modéré (2–3) épouse la courbure et améliore la prédiction hors-échantillon — c’est le vrai intérêt du polynôme, celui qu’une droite ne peut pas offrir ;
un degré élevé (8) sur-ajuste : il oscille pour coller au bruit et généralise moins bien qu’une droite.
On l’illustre en ajustant sur un petit échantillon de 40 sites (pour rendre le surapprentissage visible) et en évaluant sur les 113 restants, jamais vus lors de l’ajustement.
x_d = meuse['dist'].values
y_z = meuse['zinc'].values

rng = np.random.default_rng(42)
sample_idx = rng.choice(len(x_d), size=40, replace=False)
rest_idx   = np.setdiff1d(np.arange(len(x_d)), sample_idx)
x_tr, y_tr = x_d[sample_idx], y_z[sample_idx]
x_te, y_te = x_d[rest_idx],   y_z[rest_idx]
Exercice 4 : ajuster un polynôme
La cellule précédente a tiré 40 sites d’entraînement (x_tr, y_tr) ; les autres sites (x_te, y_te) ne servent qu’à l’évaluation. Ajuste un polynôme du degré de ton choix sur les sites d’entraînement, puis calcule son R² sur ces mêmes sites et sur les sites jamais vus. Essaie plusieurs degrés : lequel prédit le mieux les sites jamais vus ? La cellule suivante compare ensuite les degrés 1, 2, 3 et 8.
Pour cela, tu peux utiliser trois fonctions déjà rencontrées au TP2, dans la section 6.4 sur le surapprentissage :
np.polyfit(x, y, deg)ajuste par moindres carrés un polynôme de degrédegaux points (x,y). Elle renvoie ses coefficients, du plus haut degré au terme constant.np.polyval(coeffs, x)évalue le polynôme défini parcoeffsen chaque valeur dex. Le résultat, ce sont les prédictions du modèle en ces points.r2_score(y_vrai, y_predit)compare les valeurs observées aux prédictions et renvoie le R². Pour évaluer le polynôme sur un groupe de sites, il faut donc d’abord calculer ses prédictions pour ces sites.
deg    = ____   # degré du polynôme
coeffs = ____   # ajustement sur les sites d'entraînement
r2_tr  = ____   # R² sur les sites d'entraînement
r2_te  = ____   # R² sur les sites jamais vus
print(f"Degré {deg} : R² entraînement = {r2_tr:.3f} | R² sites jamais vus = {r2_te:.3f}")
Source
#@title Une solution possible (exercice 4)
deg = 2
coeffs = np.polyfit(x_tr, y_tr, deg)
r2_tr = r2_score(y_tr, np.polyval(coeffs, x_tr))
r2_te = r2_score(y_te, np.polyval(coeffs, x_te))
print(f"Degré {deg} : R² entraînement = {r2_tr:.3f} | R² sites jamais vus = {r2_te:.3f}")

# Le degré 2 prédit mieux les sites jamais vus qu'une droite (degré 1). Avec un degré élevé (8),
# le R² d'entraînement augmente encore, mais celui des sites jamais vus s'effondre :
# le polynôme colle au bruit des 40 sites (voir la cellule suivante).
Degré 2 : R² entraînement = 0.512 | R² sites jamais vus = 0.558
print(f"{'Degré':<10}{'R² (entraînement, n=40)':<26}{'R² (reste, jamais vu)':<24}")
for deg in [1, 2, 8]:
    coeffs = np.polyfit(x_tr, y_tr, deg)
    r2_tr = r2_score(y_tr, np.polyval(coeffs, x_tr))
    r2_te = r2_score(y_te, np.polyval(coeffs, x_te))
    print(f"{deg:<10}{r2_tr:<26.3f}{r2_te:<24.3f}")
# degré 3 (non tracé) — montre que le gain plafonne vite
c3 = np.polyfit(x_tr, y_tr, 3)
print(f"{'3 (réf.)':<10}{r2_score(y_tr, np.polyval(c3, x_tr)):<26.3f}{r2_score(y_te, np.polyval(c3, x_te)):<24.3f}")
Degré R² (entraînement, n=40) R² (reste, jamais vu)
1 0.374 0.422
2 0.512 0.558
8 0.576 -4.444
3 (réf.) 0.552 0.612
# Sites d'entraînement et sites jamais vus, avec les polynômes de degrés 1, 2 et 8 ajustés sur l'entraînement
graphique_polynomes(x_tr, y_tr, x_te, y_te, degres=[1, 2, 8],
                    xlabel='Distance à la rivière (normalisée 0–1)', ylabel='Zinc (ppm)',
                    titre='Régression polynomiale — degré 1 vs 2 vs 8 (ajustés sur n=40)')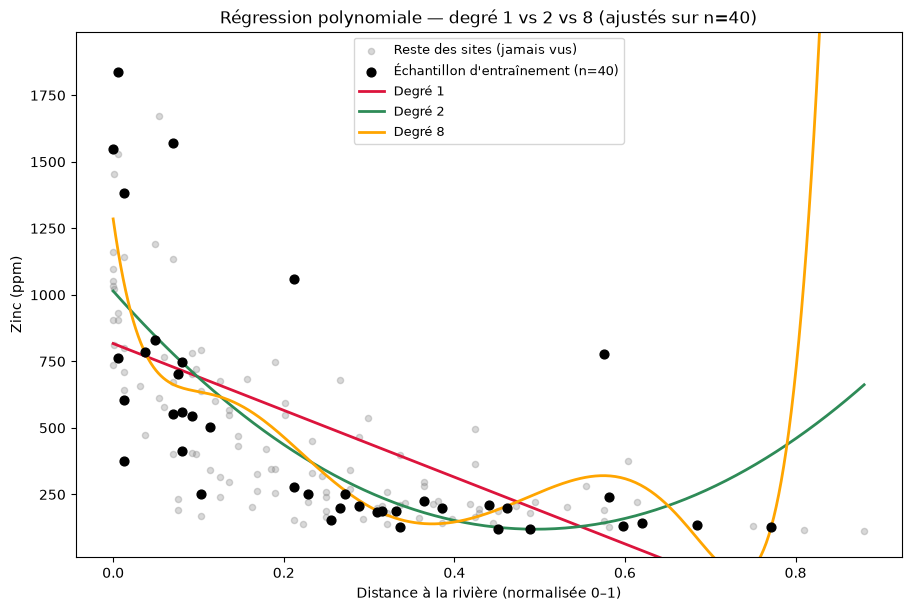
print("\nLa droite (degré 1) sous-ajuste : elle rate la décroissance courbée du zinc.")
print("Le degré 2 épouse cette courbure et AMÉLIORE le R² hors-échantillon — le vrai")
print("intérêt du polynôme, qu'une droite ne peut pas offrir (le degré 3 n'ajoute")
print("presque plus rien : le gain plafonne). Le degré 8, lui, oscille pour coller au")
print("bruit des 40 points : son R² hors-échantillon s'effondre. La flexibilité utile")
print("a une limite — on choisira le bon degré par validation (§4.7), jamais à l'œil.")
La droite (degré 1) sous-ajuste : elle rate la décroissance courbée du zinc.
Le degré 2 épouse cette courbure et AMÉLIORE le R² hors-échantillon — le vrai
intérêt du polynôme, qu'une droite ne peut pas offrir (le degré 3 n'ajoute
presque plus rien : le gain plafonne). Le degré 8, lui, oscille pour coller au
bruit des 40 points : son R² hors-échantillon s'effondre. La flexibilité utile
a une limite — on choisira le bon degré par validation (§4.7), jamais à l'œil.
4.4 GLM — un modèle adapté à une grandeur positive¶
zinc est une concentration : elle est strictement positive par nature. Rien ne garantit pourtant qu’une droite OLS y reste positive. Pire, ici elle ne l’est même pas sur les données observées : la droite zinc ~ dist croise zéro dès dist ≈ 0.63 et prédit donc des concentrations négatives pour les sites les plus éloignés de la rivière — ce qui n’a aucun sens physique.
Un GLM (Generalized Linear Model) règle ce problème en ne modélisant plus directement le zinc, mais une transformation de celui-ci. Avec le lien log et une loi Gamma (adaptée à une grandeur positive continue), on modélise :
Le membre de gauche — le log de la moyenne prédite — peut prendre n’importe quelle valeur réelle, donc la combinaison linéaire à droite s’ajuste comme dans un OLS. Mais dès qu’on inverse le lien pour revenir à l’échelle du zinc (), le résultat est mathématiquement garanti positif, quels que soient les prédicteurs.
Exercice 5 : ajuster le GLM
Ajuste le GLM décrit ci-dessus : mêmes variables que l’OLS de la section 4.2, loi Gamma et lien logarithmique. La cellule calcule ensuite son R² pour le comparer à celui de l’OLS.
Pour cela, tu peux utiliser :
smf.glm(formule, data=..., family=...)s’utilise commesmf.ols(section 4.2). La formule'cible ~ variable1 + variable2'décrit le modèle,datadonne le tableau de données, et.fit()lance l’ajustement. L’argument supplémentairefamilyprécise la loi de la variable cible et la fonction de lien.sm.families.Loi(sm.families.links.Lien())construit cette famille.Loiest le nom de la loi, par exempleGaussian,PoissonouGamma(voir la liste des lois).Lienest le nom de la fonction de lien, par exempleIdentity,LogouLogit(voir la liste des liens). Les deux noms commencent par une majuscule.
# GLM Gamma à lien log : zinc strictement positif
glm = smf.glm(____, data=meuse,
              family=____).fit()

pred_glm_all = glm.predict(meuse)
r2_glm = r2_score(meuse['zinc'], pred_glm_all)
print(f"OLS                  — R² = {ols.rsquared:.3f}")
print(f"GLM Gamma (lien log) — R² = {r2_glm:.3f}\n")
Source
#@title Une solution possible (exercice 5)
# GLM Gamma à lien log : zinc strictement positif
glm = smf.glm('zinc ~ dist + elev + om', data=meuse,
              family=sm.families.Gamma(sm.families.links.Log())).fit()

pred_glm_all = glm.predict(meuse)
r2_glm = r2_score(meuse['zinc'], pred_glm_all)
print(f"OLS                  — R² = {ols.rsquared:.3f}")
print(f"GLM Gamma (lien log) — R² = {r2_glm:.3f}\n")
OLS — R² = 0.640
GLM Gamma (lien log) — R² = 0.641
# Le vrai intérêt du GLM : une droite OLS (zinc ~ dist) prédit du zinc NÉGATIF
# pour les sites éloignés de la rivière — le GLM reste positif par construction.
ols_dist = smf.ols('zinc ~ dist', data=meuse).fit()
glm_dist = smf.glm('zinc ~ dist', data=meuse,
                   family=sm.families.Gamma(sm.families.links.Log())).fit()
grille = pd.DataFrame({'dist': [0.6, 0.7, 0.85]})   # valeurs présentes dans les données
print("Prédiction du zinc (ppm) selon la distance à la rivière :")
print(f"{'dist':>6}{'OLS':>12}{'GLM (log)':>14}")
for d in grille['dist']:
    po = ols_dist.predict(pd.DataFrame({'dist': [d]})).iloc[0]
    pg = glm_dist.predict(pd.DataFrame({'dist': [d]})).iloc[0]
    flag = '  ⚠ négatif !' if po < 0 else ''
    print(f"{d:>6}{po:>12.1f}{pg:>14.1f}{flag}")
print("\nLa droite OLS descend sous 0 (impossible pour une concentration) ; le GLM à")
print("lien log reste positif partout — c'est la garantie qu'apporte le lien.")
Prédiction du zinc (ppm) selon la distance à la rivière :
dist OLS GLM (log)
0.6 43.1 157.4
0.7 -76.5 120.7 ⚠ négatif !
0.85 -255.9 81.0 ⚠ négatif !
La droite OLS descend sous 0 (impossible pour une concentration) ; le GLM à
lien log reste positif partout — c'est la garantie qu'apporte le lien.
4.5 GAM thématique — splines sur les variables de terrain¶
Un GAM remplace la droite de régression de chaque prédicteur par une courbe lisse (B-spline). Cela permet de capturer des relations non-linéaires — par exemple un effet de la distance qui s’atténue au-delà d’un certain seuil.
La pénalité de lissage (alpha) contrôle la souplesse de la courbe : plus alpha est grand, plus la courbe se rapproche d’une droite. En statsmodels, le GAM utilise des B-splines pénalisées (P-splines).
Le graphe d’effets partiels (plot_partial) montre la contribution de chaque variable à la prédiction, toutes choses égales par ailleurs.
# Base de B-splines pour les 3 variables de terrain
# df=6 : 6 fonctions de base par variable ; degree=3 : splines cubiques
bs_th = BSplines(X_th, df=[6, 6, 6], degree=[3, 3, 3])

# Ajustement du GAM avec pénalité de lissage (alpha = [1, 1, 1])
gam_th = GLMGam(y, smoother=bs_th, alpha=[1, 1, 1]).fit()
r2_gam_th = r2_score(y, gam_th.fittedvalues)
print(f"GAM thématique — R² = {r2_gam_th:.3f}  (vs OLS : {ols.rsquared:.3f})")
GAM thématique — R² = 0.679 (vs OLS : 0.640)
# Effets partiels : contribution de chaque variable lisse, avec son intervalle de confiance
effets_partiels(gam_th, variables=features, noms=labels,
                titre=f"GAM thématique — effets partiels (R² = {r2_gam_th:.3f})")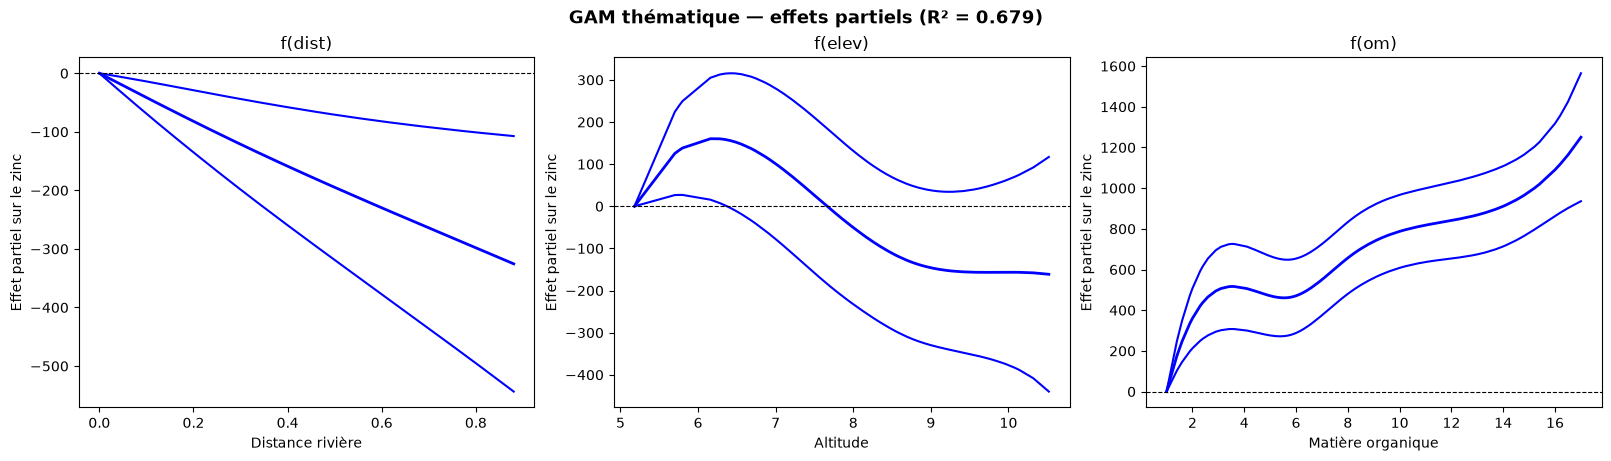
4.6 GAM spatial, ajouter un lisseur géographique¶
La carte du zinc (§4.1) montrait un gradient spatial marqué (concentrations élevées le long de la rivière). Une partie de ce gradient n’est pas capturée par les seules variables de terrain.
On l’intègre en ajoutant un lisseur spatial 2D : — une surface lisse sur les coordonnées des sites. Cela revient à modéliser l’autocorrélation spatiale résiduelle.
Le lisseur spatial est ajusté avec une pénalité plus faible (alpha plus petit) pour lui permettre de capturer des gradients larges.
# Base de B-splines : variables de terrain + coordonnées spatiales
# Les coordonnées (x, y) reçoivent plus de fonctions de base (df=8)
# et une pénalité plus faible (alpha=1e-3) pour capturer le gradient spatial
bs_sp = BSplines(X_sp, df=[6, 6, 6, 8, 8], degree=[3, 3, 3, 3, 3])
gam_sp = GLMGam(y, smoother=bs_sp, alpha=[1, 1, 1, 1e-3, 1e-3]).fit()
r2_gam_sp = r2_score(y, gam_sp.fittedvalues)

print(f"OLS               R² = {ols.rsquared:.3f}")
print(f"GAM thématique    R² = {r2_gam_th:.3f}")
print(f"GAM spatial       R² = {r2_gam_sp:.3f}  ← amélioration due au lisseur géographique")
OLS R² = 0.640
GAM thématique R² = 0.679
GAM spatial R² = 0.825 ← amélioration due au lisseur géographique
# Résidus OLS vs GAM spatial (cartes de points)
resid_ols = y - ols.predict(meuse).values
resid_gam = y - gam_sp.fittedvalues
pred_gam  = gam_sp.fittedvalues
vabs = np.percentile(np.abs(resid_ols), 97)   # même échelle de couleurs pour les deux cartes de résidus

ax1, ax2, ax3 = nouvelle_figure(3, 'Comparaison OLS vs GAM spatial — résidus et prédictions')
carte_points(meuse['x'], meuse['y'], resid_ols, titre=f'Résidus OLS (R²={ols.rsquared:.2f})', limite=vabs, ax=ax1)
carte_points(meuse['x'], meuse['y'], resid_gam, titre=f'Résidus GAM spatial (R²={r2_gam_sp:.2f})', limite=vabs, ax=ax2)
carte_points(meuse['x'], meuse['y'], pred_gam, titre='Zinc prédit (GAM spatial)', ax=ax3)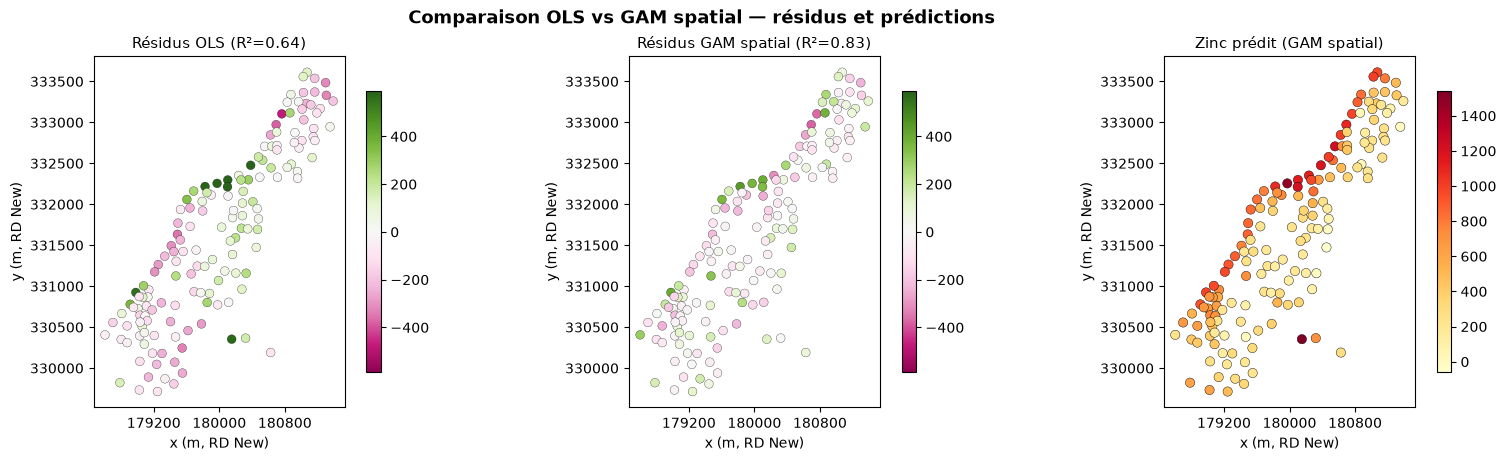
4.7 Validation croisée K-fold¶
Les R² vus jusqu’ici (OLS, polynomiale, GLM, GAM) sont pour la plupart calculés sur les mêmes données que celles utilisées pour l’ajustement : ils sont optimistes. Un modèle plus complexe peut avoir un R² d’entraînement élevé tout en généralisant mal à de nouvelles observations (surapprentissage) — on vient de le voir avec le polynôme de degré 8 (§4.3).
La validation croisée à K plis (K-fold CV) fournit une estimation honnête, applicable uniformément aux cinq modèles :
Diviser les 153 sites en K=5 groupes (plis)
Pour chaque pli : entraîner sur les 4 autres, évaluer sur celui-ci
Moyenner les R² des 5 plis
Pour que la CV fonctionne avec les GAM, on utilise un pipeline sklearn équivalent :
SplineTransformer (base B-spline, knots sur quantiles) + Ridge (pénalisation L₂ ≈ pénalité de lissage). Le GLM n’a pas de wrapper scikit-learn standard : sa CV est effectuée manuellement, pli par pli, avec statsmodels.
Exercice 6 : validation croisée de l’OLS
Complète la cellule à trous ci-dessous pour découper les 153 sites en K = 5 plis, puis calculer le R² de l’OLS en validation croisée, à partir des variables de terrain X_th et du zinc y. Les cellules suivantes appliquent la même démarche aux autres modèles.
Pour cela, tu peux utiliser :
KFold(n_splits=K, shuffle=True, random_state=...)définit un découpage des données enKplis.shuffle=Truemélange les sites avant de les répartir, etrandom_statefixe ce mélange, pour obtenir le même découpage à chaque exécution.cross_val_score(modele, X, y, cv=decoupage, scoring='r2')entraînemodelesur tous les plis sauf un, puis l’évalue sur le pli restant, et recommence pour chaque pli. Elle renvoie un tableau avec un R² par pli.LinearRegression()est le modèle de régression linéaire (OLS) de scikit-learn, déjà utilisé au TP2. Inutile de l’entraîner avec.fit():cross_val_scores’en charge pour chaque pli.
kf = KFold(n_splits=____, shuffle=True, random_state=42)

# 1. OLS (référence linéaire)
r2_cv_ols = ____
print("R² par pli :", r2_cv_ols.round(3), "| moyenne :", round(r2_cv_ols.mean(), 3))
Source
#@title Une solution possible (exercice 6)
kf = KFold(n_splits=5, shuffle=True, random_state=42)

# 1. OLS (référence linéaire)
r2_cv_ols = cross_val_score(LinearRegression(), X_th, y, cv=kf, scoring='r2')
print("R² par pli :", r2_cv_ols.round(3), "| moyenne :", round(r2_cv_ols.mean(), 3))
R² par pli : [0.712 0.572 0.568 0.417 0.677] | moyenne : 0.589
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures

# 2. Régression polynomiale (degré 2, sur les 3 variables de terrain)
pipe_poly = make_pipeline(PolynomialFeatures(degree=2, include_bias=False), LinearRegression())
r2_cv_poly = cross_val_score(pipe_poly, X_th, y, cv=kf, scoring='r2')
r2_poly_train = r2_score(y, pipe_poly.fit(X_th, y).predict(X_th))
# 3. GLM (Gamma, lien log) — pas de wrapper scikit-learn standard : CV manuelle
r2_cv_glm = []
for tr_idx, te_idx in kf.split(X_th):
train_df, test_df = meuse.iloc[tr_idx], meuse.iloc[te_idx]
glm_fold = smf.glm('zinc ~ dist + elev + om', data=train_df,
family=sm.families.Gamma(sm.families.links.Log())).fit()
pred_fold = glm_fold.predict(test_df)
r2_cv_glm.append(r2_score(test_df['zinc'], pred_fold))
r2_cv_glm = np.array(r2_cv_glm)# 4. GAM thématique ≈ SplineTransformer + Ridge (pénalité L2 ≈ pénalité de lissage)
pipe_th = make_pipeline(
SplineTransformer(n_knots=5, degree=3, knots='quantile'),
Ridge(alpha=10)
)
r2_cv_gam_th = cross_val_score(pipe_th, X_th, y, cv=kf, scoring='r2')
# 5. GAM spatial ≈ SplineTransformer + Ridge sur [terrain + x, y]
pipe_sp = make_pipeline(
SplineTransformer(n_knots=5, degree=3, knots='quantile'),
Ridge(alpha=0.1)
)
r2_cv_gam_sp = cross_val_score(pipe_sp, X_sp, y, cv=kf, scoring='r2')# Tableau récapitulatif
results = pd.DataFrame({
'Modèle': ['OLS', 'Polynomial (deg. 2)', 'GLM (Gamma, log)', 'GAM thématique', 'GAM spatial'],
'R² entraînement': [ols.rsquared, r2_poly_train, r2_glm, r2_gam_th, r2_gam_sp],
'R² CV (5-fold)': [r2_cv_ols.mean(), r2_cv_poly.mean(), r2_cv_glm.mean(), r2_cv_gam_th.mean(), r2_cv_gam_sp.mean()],
'± (écart-type)': [r2_cv_ols.std(), r2_cv_poly.std(), r2_cv_glm.std(), r2_cv_gam_th.std(), r2_cv_gam_sp.std()],
}).round(3)
print(results.to_string(index=False))
print()
print("✓ Polynomial / GAM thématique : captent la courbure de `dist` → gain net sur OLS.")
print("✓ GLM : garde des prédictions positives, sans complexité supplémentaire majeure.")
print("✓ GAM spatial : R² CV le plus élevé → le gradient géographique (proximité de la")
print(" rivière) est un signal réel et généralisable, pas un artefact de l'échantillon.") Modèle R² entraînement R² CV (5-fold) ± (écart-type)
OLS 0.640 0.589 0.103
Polynomial (deg. 2) 0.707 0.588 0.093
GLM (Gamma, log) 0.641 0.580 0.181
GAM thématique 0.679 0.621 0.024
GAM spatial 0.825 0.741 0.038
✓ Polynomial / GAM thématique : captent la courbure de `dist` → gain net sur OLS.
✓ GLM : garde des prédictions positives, sans complexité supplémentaire majeure.
✓ GAM spatial : R² CV le plus élevé → le gradient géographique (proximité de la
rivière) est un signal réel et généralisable, pas un artefact de l'échantillon.
4.8 Incertitude liée au découpage — validation croisée répétée¶
Le tableau précédent donne une seule valeur de R² CV par modèle — celle obtenue avec random_state=42. Mais avec seulement 153 sites, répartis aléatoirement en 5 plis de ~31 observations, le découpage lui-même est une source de variabilité : un autre tirage donnerait un R² CV légèrement différent, simplement parce que les plis contiendraient des sites différents.
On répète la validation croisée 20 fois, avec un random_state différent à chaque fois, pour visualiser la distribution du R² CV plutôt qu’un seul chiffre. Plus le jeu de données est petit, plus cette variabilité est grande — un avertissement à garder en tête chaque fois qu’on compare deux R² CV calculés une seule fois.
⚠️ Ce n’est pas du bootstrap, même si les deux techniques « répètent une procédure aléatoire plusieurs fois » : ici, on ré-utilise toujours les 153 mêmes sites, seul le découpage en plis change. Le bootstrap (§4.9) tire un nouvel échantillon de sites à chaque répétition — une question différente.
n_repeats = 20
r2_repeats_ols    = []
r2_repeats_gam_sp = []
for seed in range(n_repeats):
    kf_r = KFold(n_splits=5, shuffle=True, random_state=seed)
    r2_repeats_ols.append(cross_val_score(LinearRegression(), X_th, y, cv=kf_r, scoring='r2').mean())
    r2_repeats_gam_sp.append(cross_val_score(pipe_sp, X_sp, y, cv=kf_r, scoring='r2').mean())

r2_repeats_ols    = np.array(r2_repeats_ols)
r2_repeats_gam_sp = np.array(r2_repeats_gam_sp)
boites({'OLS': r2_repeats_ols, 'GAM spatial': r2_repeats_gam_sp},
ylabel=f'R² CV moyen (5-fold), sur {n_repeats} répétitions',
titre=f'Variabilité du R² CV selon le découpage aléatoire (n = {len(y)} sites)')
print(f"OLS : R² CV = {r2_repeats_ols.mean():.3f} ± {r2_repeats_ols.std():.3f} "
f"(plage {r2_repeats_ols.min():.3f} – {r2_repeats_ols.max():.3f})")
print(f"GAM spatial : R² CV = {r2_repeats_gam_sp.mean():.3f} ± {r2_repeats_gam_sp.std():.3f} "
f"(plage {r2_repeats_gam_sp.min():.3f} – {r2_repeats_gam_sp.max():.3f})")
print()
print("Le R² CV varie d'un tirage à l'autre, d'autant plus que n est petit (153 sites).")
print("Le GAM spatial reste nettement au-dessus de l'OLS sur tous les tirages : son")
print("avantage (le gradient géographique) est robuste au découpage, pas un coup de chance")
print("d'un seul essai.")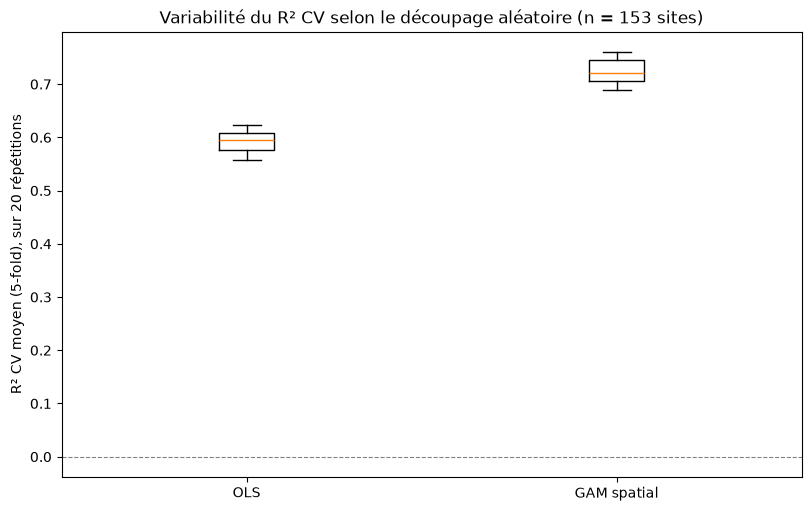
OLS         : R² CV = 0.594 ± 0.019  (plage 0.557 – 0.623)
GAM spatial : R² CV = 0.725 ± 0.022  (plage 0.690 – 0.761)

Le R² CV varie d'un tirage à l'autre, d'autant plus que n est petit (153 sites).
Le GAM spatial reste nettement au-dessus de l'OLS sur tous les tirages : son
avantage (le gradient géographique) est robuste au découpage, pas un coup de chance
d'un seul essai.
4.9 Bootstrap, intervalle de confiance par ré-échantillonnage¶
La CV répétée (§4.8) fait varier le découpage en plis, mais utilise toujours les mêmes 153 sites. Le bootstrap répond à une question différente : si on avait observé un autre échantillon de sites dans la plaine de la Meuse (même processus, tirage différent), quelle serait la variabilité du R² ?
Le principe : tirer, fois, un nouvel échantillon de 153 sites avec remise depuis les données observées (certains sites apparaissent plusieurs fois, d’autres pas du tout), ré-ajuster le modèle sur chaque tirage, et regarder la distribution des R² obtenus. Pour que chaque réplication reste une évaluation hors échantillon (et non optimiste comme un R² d’entraînement), on évalue chaque modèle sur les sites jamais tirés dans cette réplication: les points out-of-bag (OOB), qui représentent en moyenne environ 37 % de l’échantillon original.
Bootstrap et CV répétée sont deux outils complémentaires, pas concurrents, pour quantifier l’incertitude d’un R² : la CV répétée mesure l’incertitude due au découpage train/test ; le bootstrap mesure l’incertitude due à l’échantillonnage de la population source. Dans un projet réel, les deux questions sont légitimes, et rien n’empêche de les utiliser ensemble.
n_boot = 500
n = len(meuse)
rng_boot = np.random.default_rng(1)

r2_boot = []
for _ in range(n_boot):
    boot_idx = rng_boot.integers(0, n, size=n)          # tirage avec remise (même taille que l'original)
    oob_idx  = np.setdiff1d(np.arange(n), boot_idx)     # sites jamais tirés (hors échantillon)
    if len(oob_idx) < 5:
        continue   # cas rare : trop peu de points OOB pour évaluer

    pipe_boot = make_pipeline(SplineTransformer(n_knots=5, degree=3, knots='quantile'), Ridge(alpha=0.1))
    pipe_boot.fit(X_sp[boot_idx], y[boot_idx])
    r2_boot.append(r2_score(y[oob_idx], pipe_boot.predict(X_sp[oob_idx])))

r2_boot = np.array(r2_boot)
ci_low, ci_high = np.percentile(r2_boot, [2.5, 97.5])
histogramme(r2_boot, xlabel='R² (GAM spatial, évalué hors échantillon — OOB)', ylabel='Fréquence',
titre=f'Distribution bootstrap du R² — GAM spatial ({len(r2_boot)} réplications)',
intervalle=(ci_low, ci_high))
print(f"R² bootstrap (OOB) : moyenne = {r2_boot.mean():.3f} écart-type = {r2_boot.std():.3f}")
print(f"Intervalle de confiance à 95 % : [{ci_low:.3f}, {ci_high:.3f}]")
print()
print("Le bootstrap inclut l'incertitude due au fait que nos 153 sites ne sont eux-mêmes")
print("qu'UN échantillon parmi d'autres possibles, une source de variabilité que la CV")
print("répétée (qui réutilise toujours les mêmes 153 sites) ne capture pas.")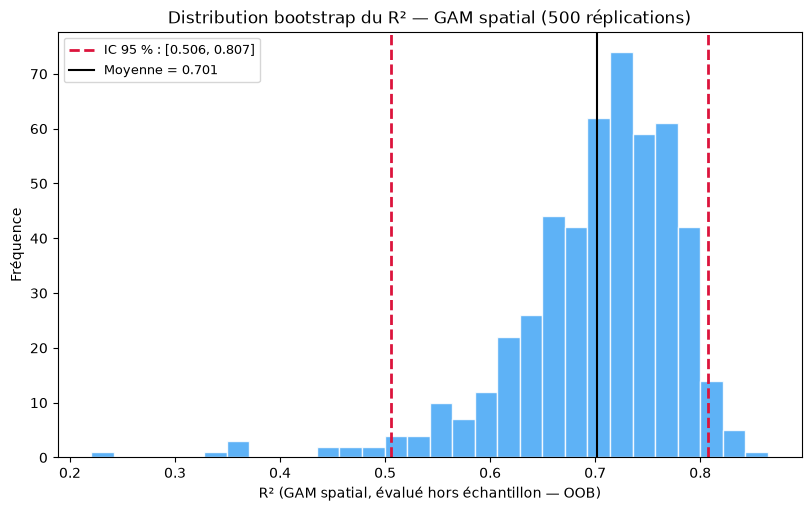
R² bootstrap (OOB) : moyenne = 0.701  écart-type = 0.079
Intervalle de confiance à 95 % : [0.506, 0.807]

Le bootstrap inclut l'incertitude due au fait que nos 153 sites ne sont eux-mêmes
qu'UN échantillon parmi d'autres possibles, une source de variabilité que la CV
répétée (qui réutilise toujours les mêmes 153 sites) ne capture pas.
Récapitulatif¶
Parties 1–3 : Géotraitement vectoriel (parallèle du TP QGIS 3)¶
| Opération QGIS | Code Python clé |
|---|---|
| Sélection par expression | gdf[gdf['col'].str.contains(...)] |
| Fusionner (dissolve) | gdf.dissolve() |
| Couper (Clip) | gpd.clip(layer, mask) |
| Zone tampon (Buffer) | .buffer(dist) + .union_all() |
| Double buffer (ZDB) | .buffer(+75).union_all() puis .buffer(-75) |
| Union / Différence / Intersection | geom_a.union/difference/intersection(geom_b) |
Partie 4 : Régression non-linéaire : polynômes, GLM et GAM (jeu Meuse)¶
| Étape | Code clé |
|---|---|
| Charger données + points | pd.read_csv(MEUSE_PATH) + gpd.points_from_xy(x, y) |
| Baseline OLS | smf.ols('zinc ~ dist + elev + om', data=meuse).fit() |
| Régression polynomiale | np.polyfit(x, y, deg=d) / PolynomialFeatures(degree=d) |
| GLM (Gamma, lien log) | smf.glm('zinc ~ ...', family=sm.families.Gamma(sm.families.links.Log())).fit() |
| Base B-splines | BSplines(X, df=[6,6,6], degree=[3,3,3]) |
| Ajuster GAM | GLMGam(y, smoother=bs, alpha=[1,1,1]).fit() |
| Effets partiels | gam.plot_partial(i, ax=ax, plot_se=True) |
| Lisseur spatial | ajouter x, y à la base B-splines, alpha plus faible |
| Validation croisée | cross_val_score(pipe, X, y, cv=KFold(5), scoring='r2') |
| CV répétée (incertitude du découpage) | répéter la CV avec plusieurs random_state |
| Bootstrap OOB (incertitude d’échantillonnage) | tirage avec remise + évaluation sur les points jamais tirés |
Concepts clés :
| Concept | Signification |
|---|---|
| R² entraînement | Mesuré sur les mêmes données → toujours optimiste |
| R² CV (5-fold) | Estimation honnête de la généralisation, elle-même incertaine (§4.8) |
| Surapprentissage | R² train ≫ R² CV → modèle trop complexe pour les données |
| Lien (GLM) | Transformation (ici log) qui garantit des prédictions valides — ici toujours |
| Lisseur spatial | capte l’autocorrélation spatiale résiduelle (gradient de la rivière) |
| Effet partiel | Contribution de à , toutes choses égales par ailleurs |
🎯 Bonnes pratiques ML : comparer et quantifier¶
| Principe | Où on l’a vu |
|---|---|
| Le choix du modèle commence par le type de la cible (continu / positif-borné / catégoriel) | §4 (tableau de décision) |
| Comparer plusieurs modèles candidats avec la même procédure d’évaluation (K-fold CV) | §4.7 |
| La flexibilité d’un modèle n’est pas gratuite : plus de paramètres libres augmente le risque de surapprentissage, sauf si les données le justifient (ici, une vraie courbure) | §4.3, §4.5 vs §4.6 |
| Une estimation de performance a elle-même une incertitude — répéter la CV et/ou utiliser le bootstrap avant de conclure | §4.8–4.9 |
Règle clé : le R² d’entraînement ne dit pas si le modèle généralisera, et un R² CV calculé une seule fois n’est lui-même qu’une estimation bruitée (§4.8) — le bootstrap (§4.9) en donne une seconde estimation, généralement plus large. Le GAM spatial capture un effet géographique réel (le gradient de la rivière) qui reste robuste en validation croisée.
📝 Quiz Moodle¶
Une fois ce TP terminé, teste tes connaissances avec le quiz Moodle du TP3 :
👉 Ouvrir le quiz du TP3 sur Moodle (accès réservé aux étudiant·e·s UNIL)