TP2 : Sélections, jointures et relations avec GeoPandas
Exécution dans le cloud : ce notebook peut aussi tourner dans le cloud (Colab, Kaggle, Renku). Avant de lancer les cellules, télécharge
tp2.gpkgdepuis le dossier OneDrive du cours et dépose-les dans le répertoire de travail du notebook (Colab : panneau 📁 → Upload ; Kaggle : File → Upload ; Renku : déjà dans le projet). Procédure complète : docs/cloud -badges .md.
TP2 : Sélections, jointures et relations avec GeoPandas¶
Ce TP est le pendant Python du TP QGIS 02. L’objectif est de travailler avec le même fichier tp2.gpkg et d’effectuer les mêmes opérations — sélections attributaires, requêtes spatiales, jointures et cartographie — mais en Python avec la librairie GeoPandas.
import geopandas as gpd
import pandas as pd
import sqlite3
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches
import numpy as np
1. Chargement et exploration des données¶
Toutes les données sont stockées dans le fichier tp2.gpkg que tu peux trouver dans le dossier OneDrive du cours. Ce fichier contient les couches géographiques et les tables attributaires suivantes :
| Couche / Table | Type | Description |
|---|---|---|
Communes | Polygone | 382 communes vaudoises |
geology_VD | Polygone | Carte géologique du canton de Vaud |
LI_Accident_tecto | Ligne | Accidents tectoniques |
BatimentsUNIL | Polygone | Bâtiments du campus UNIL |
Parcelles | Polygone | Parcelles cadastrales |
Communes_CH | Polygone | Communes suisses (niveau national) — géométries pour la §6.7 |
VoituresPlus | Table | Véhicules / 1 000 hab. par commune (2010) |
Proprietaires | Table | Propriétaires de parcelles |
Proprietaire_Parcelle | Table | Table de relation parcelles ↔ propriétaires |
Les couches géographiques se différencient des tables attributaires car elles possèdent une colonne de géométrie contenant la forme et la localisation de chaque objet géométrique. Pour pouvoir être manipulées en Python, les couches géométriques sont téléchargées sous forme de GeoDataFrame et les tables attributaires sous forme de DataFrame.
# Chemin vers les données du TP2 : Remplace par le chemin vers ton fichier tp2.gpkg
DATA_PATH = 'tp2.gpkg'
1.1 - Chargement et exploration des couches géographiques¶
# --- Chargement des couches géographiques ---
communes  = gpd.read_file(DATA_PATH, layer='Communes')
geologie  = gpd.read_file(DATA_PATH, layer='geology_VD')
accidents = gpd.read_file(DATA_PATH, layer='LI_Accident_tecto')
batiments = gpd.read_file(DATA_PATH, layer='BatimentsUNIL')
parcelles = gpd.read_file(DATA_PATH, layer='Parcelles')


for nom, gdf in [('Communes', communes), ('geology_VD', geologie),
                 ('LI_Accident_tecto', accidents), ('BatimentsUNIL', batiments),
                 ('Parcelles', parcelles)]:
    print(f"{nom:<25}  {str(gdf.shape):<12}  "
          f"CRS: EPSG:{gdf.crs.to_epsg()}  geom: {gdf.geom_type.unique()[0]}")
Communes (382, 8) CRS: EPSG:21781 geom: MultiPolygon
geology_VD (784, 23) CRS: EPSG:21781 geom: MultiPolygon
LI_Accident_tecto (12740, 7) CRS: EPSG:21781 geom: MultiLineString
BatimentsUNIL (24, 6) CRS: EPSG:21781 geom: MultiPolygon
Parcelles (146, 9) CRS: EPSG:21781 geom: MultiPolygon
# --- Vue d'ensemble : superposer les couches du canton de Vaud ---
fig, ax = plt.subplots(figsize=(10, 8))

communes.plot(ax=ax, color='#f5f0e8', edgecolor='#888', linewidth=0.5)
geologie.plot(ax=ax, column='TECTO_F', cmap='tab20', alpha=0.4, legend=False)
accidents.plot(ax=ax, color='darkred', linewidth=0.4, alpha=0.6)

patches = [
    mpatches.Patch(facecolor='#f5f0e8', edgecolor='#888', label='Communes'),
    mpatches.Patch(color='steelblue', alpha=0.6, label='Géologie (TECTO_F)'),
    mpatches.Patch(color='darkred', label='Accidents tectoniques'),
]
ax.legend(handles=patches, loc='lower right', fontsize=9)
ax.set_title('Canton de Vaud — données tp2.gpkg', fontsize=13)
ax.set_axis_off()
plt.tight_layout()
plt.show()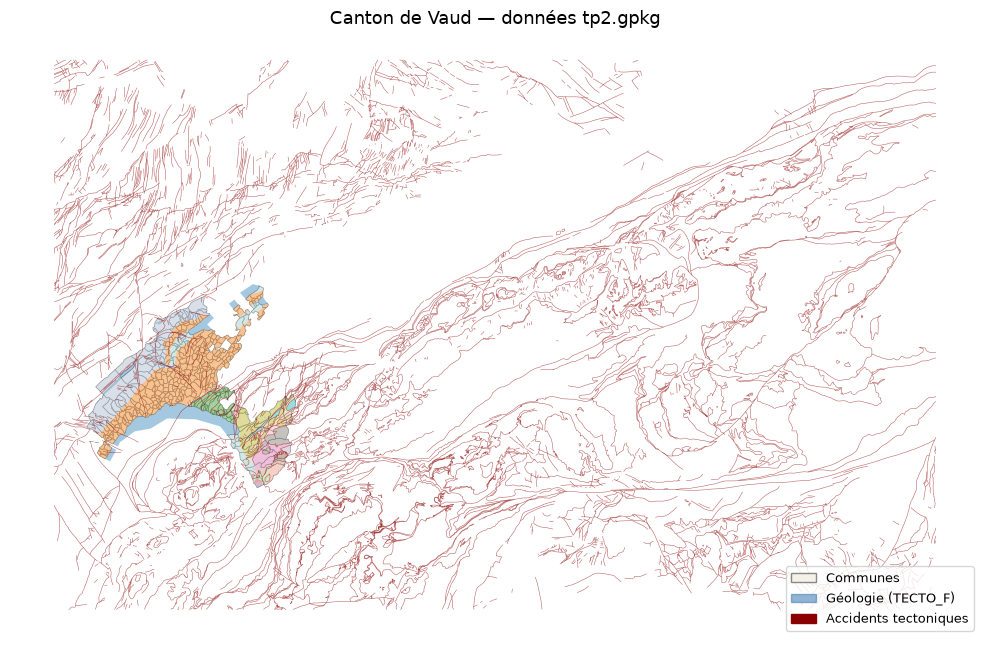
1.2 - Chargement et exploration des tables attributaires¶
# --- Tables attributaires (sans géométrie) ---
# Ces tables sont stockées dans le GeoPackage mais sans colonne géométrique.
# On les lit via sqlite3 (ou pd.read_sql).
con = sqlite3.connect(DATA_PATH)
voitures      = pd.read_sql('SELECT * FROM VoituresPlus', con)
proprietaires = pd.read_sql('SELECT * FROM Proprietaires', con)
prop_parc     = pd.read_sql('SELECT * FROM Proprietaire_Parcelle', con)
con.close()

print(f"VoituresPlus          : {voitures.shape}  cols={voitures.columns.tolist()}")
print(f"Proprietaires         : {proprietaires.shape}  cols={proprietaires.columns.tolist()}")
print(f"Proprietaire_Parcelle : {prop_parc.shape}  cols={prop_parc.columns.tolist()}")
print()
voitures.head()
VoituresPlus : (319, 6) cols=['fid', 'OBJECTID', 'Communes', 'Voitures_de_tourisme', 'Motocycles', 'Voitures_de_tourisme__1000_hab']
Proprietaires : (10, 4) cols=['fid', 'OBJECTID', 'NO_PROPRI', 'NOM_PROPRI']
Proprietaire_Parcelle : (166, 4) cols=['fid', 'OBJECTID', 'NO_IMM', 'NO_PROPRI']
2. Requêtes attributaires¶
Les requêtes attributaires permettent de sélectionner des entités (lignes) en fonction de la valeur de leurs attributs. C’est l’équivalent Python des sélections par expression dans QGIS.
2.1 Sélection simple¶
La sélection simple permet de sélectionner les entités dont un attribut est égal à une certaine valeur.
Elle peut être réalisée en utilisant l’expression gdf[gdf['col'] == valeur].
🗺️ Parallèle QGIS : Select Features by Value sur le champ
LEG_TEC_3.Expression QGIS équivalente :
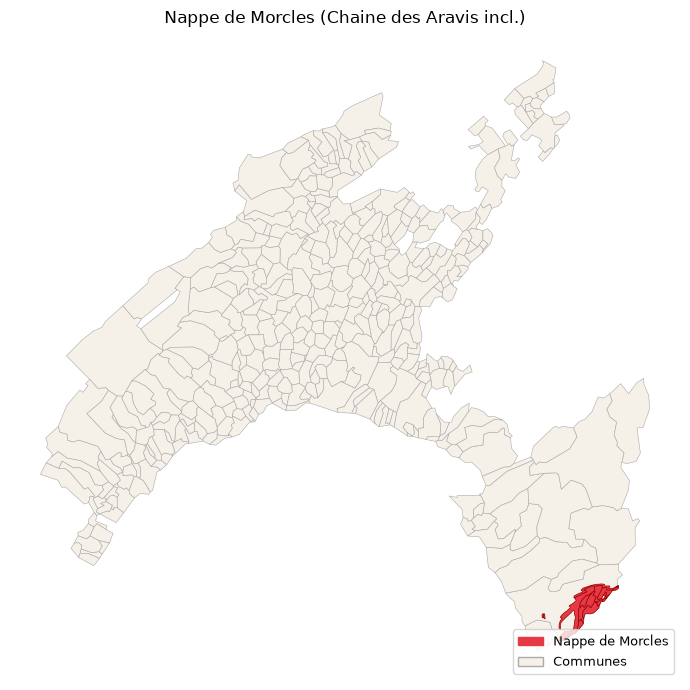
"LEG_TEC_3" = 'Nappe de Morcles (Chaine des Aravis incl.)'
# --- 2.1 Sélection simple ---
nappe_morcles = geologie[
    geologie['LEG_TEC_3'] == 'Nappe de Morcles (Chaine des Aravis incl.)'
]

print(f"Entités sélectionnées : {len(nappe_morcles)}")
print(f"Surface totale        : {nappe_morcles['AREA'].sum() / 1e6:.1f} km²")

fig, ax = plt.subplots(figsize=(10, 7))
communes.plot(ax=ax, color='#f5f0e8', edgecolor='#aaa', linewidth=0.4)
nappe_morcles.plot(ax=ax, color='#e63946', edgecolor='#900', linewidth=0.5)
ax.set_title("Nappe de Morcles (Chaine des Aravis incl.)", fontsize=12)
ax.set_axis_off()
# Légende manuelle
legend_patches = [
    mpatches.Patch(color='#e63946', label='Nappe de Morcles'),
    mpatches.Patch(facecolor='#f5f0e8', edgecolor='#aaa', label='Communes'),
]
ax.legend(handles=legend_patches, fontsize=9, loc='lower right')
plt.tight_layout()
plt.show()
Entités sélectionnées : 15
Surface totale : 25.2 km²
2.2 Sélection par intervalle¶
La sélection par intervalle permet de sélectionner les entités dont un attribut appartient à une plage de valeur spécifique. Elle peut être réalisée en utilisant l’expression gdf[(gdf['col'] >= min) & (gdf['col'] <= max)].
🗺️ Parallèle QGIS :
"AREA" >= 100000 AND "AREA" <= 500000> Sélectionne les unités géologiques dont la surface est comprise entre 0.1 km² et 0.5 km².
# --- 2.2 Sélection par intervalle ---
petites_unites = geologie[
    (geologie['AREA'] >= 100_000) &
    (geologie['AREA'] <= 500_000)
]

print(f"Entités sélectionnées : {len(petites_unites)}")
print(f"Surface min / max     : {petites_unites['AREA'].min()/1e6:.3f} – "
      f"{petites_unites['AREA'].max()/1e6:.3f} km²")
print()
print("Top 8 unités les plus grandes dans la sélection :")
print(petites_unites[['OBJECTID', 'LEG_TEC_3', 'AREA']]
      .sort_values('AREA', ascending=False).head(8).to_string(index=False))
Entités sélectionnées : 257
Surface min / max : 0.101 – 0.499 km²
Top 8 unités les plus grandes dans la sélection :
OBJECTID LEG_TEC_3 AREA
371 Nappe des Prealpes medianes plastiques 499113.76660
59 Molasse du plateau non deformee 497617.47903
597 Nappe des Prealpes medianes plastiques 497112.90123
405 Nappe des Prealpes medianes plastiques 495606.51972
416 493335.01153
121 Molasse du plateau non deformee 488855.05078
675 Molasse du plateau non deformee 483708.52763
684 483411.69578
2.3 Sélection multiple¶
La sélection multiple permet de sélectionner les entités dont un attribut est égal à une des valeurs présentes dans une liste. Elle peut être réalisée en utilisant l’expression gdf[gdf[col].isin(liste_val)].
🗺️ Parallèle QGIS :
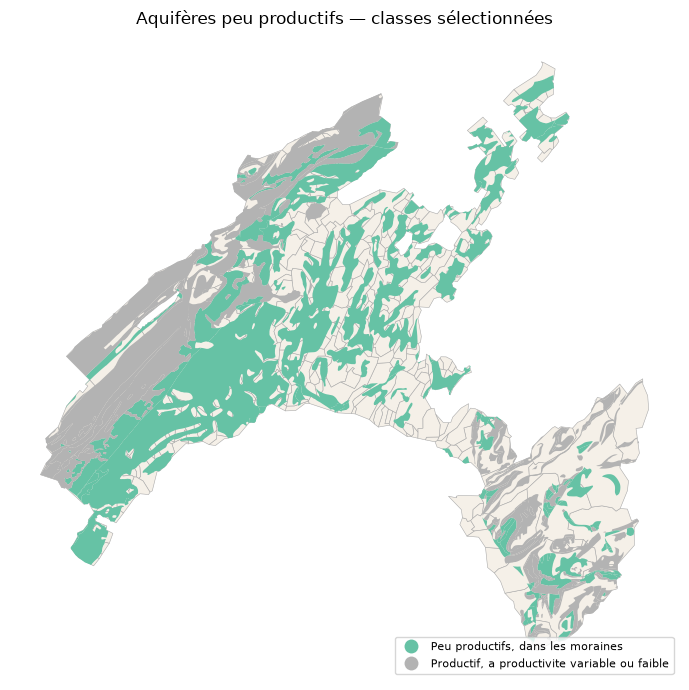
"PRODUCTIV" IN ('Peu productifs, dans les moraines',
                'Productif, a productivite variable ou faible')
# --- 2.3 Sélection multiple avec .isin() ---
productivites = [
    'Peu productifs, dans les moraines',
    'Productif, a productivite variable ou faible'
]
peu_productifs = geologie[geologie['PRODUCTIV'].isin(productivites)]

print(f"Entités sélectionnées : {len(peu_productifs)}")
print()
print("Répartition par classe :")
print(peu_productifs['PRODUCTIV'].value_counts().to_string())

fig, ax = plt.subplots(figsize=(10, 7))
communes.plot(ax=ax, color='#f5f0e8', edgecolor='#aaa', linewidth=0.4)
peu_productifs.plot(ax=ax, column='PRODUCTIV', cmap='Set2', legend=True,
                    legend_kwds={'loc': 'lower right', 'fontsize': 8})
ax.set_title("Aquifères peu productifs — classes sélectionnées", fontsize=12)
ax.set_axis_off()
plt.tight_layout()
plt.show()
Entités sélectionnées : 334
Répartition par classe :
PRODUCTIV
Productif, a productivite variable ou faible 177
Peu productifs, dans les moraines 157
2.4 La méthode .query()¶
.query() permet d’exprimer des conditions sous forme de chaîne de caractères,
proche de la syntaxe SQL utilisée dans QGIS.
# Condition simple
gdf.query("col == 'valeur'")

# Intervalle
gdf.query("col >= 100 and col <= 500")

# Variable externe (préfixe @)
seuil = 1000
gdf.query("col > @seuil")
# --- 2.4 Requêtes avec .query() ---
# Sélection simple
nappe_q = geologie.query("LEG_TEC_3 == 'Nappe de Morcles (Chaine des Aravis incl.)'")
# Sélection par intervalle
petites_q = geologie.query("AREA >= 100_000 and AREA <= 500_000")
# Variable externe (préfixe @)
seuil_bas, seuil_haut = 1_000_000, 10_000_000
grandes_unites = geologie.query("AREA >= @seuil_bas and AREA <= @seuil_haut")
# Condition combinée avec méthode de chaîne (nécessite engine='python')
molasse = geologie.query(
"LEG_TEC_3.str.contains('Molasse', na=False) and AREA > 1_000_000",
engine='python'
)
print(f"Nappe de Morcles : {len(nappe_q)} entités")
print(f"Petites unités (0.1–0.5 km²) : {len(petites_q)} entités")
print(f"Grandes unités (1–10 km²): {len(grandes_unites)} entités")
print(f"Molasse (> 1 km²) : {len(molasse)} entités")Nappe de Morcles : 15 entités
Petites unités (0.1–0.5 km²) : 257 entités
Grandes unités (1–10 km²): 270 entités
Molasse (> 1 km²) : 101 entités
3. Requêtes spatiales¶
Une requête spatiale sélectionne des entités en fonction de leur relation géométrique avec d’autres entités.
En Python, les requêtes spatiales peuvent être réalisées en utilisant l’expression gpd.sjoin(gdf1, gdf2, predicate='intersects').
🗺️ Parallèle QGIS : Sélection par localisation (Select by Location)
Dans l’exemple ci-dessous, on combine :
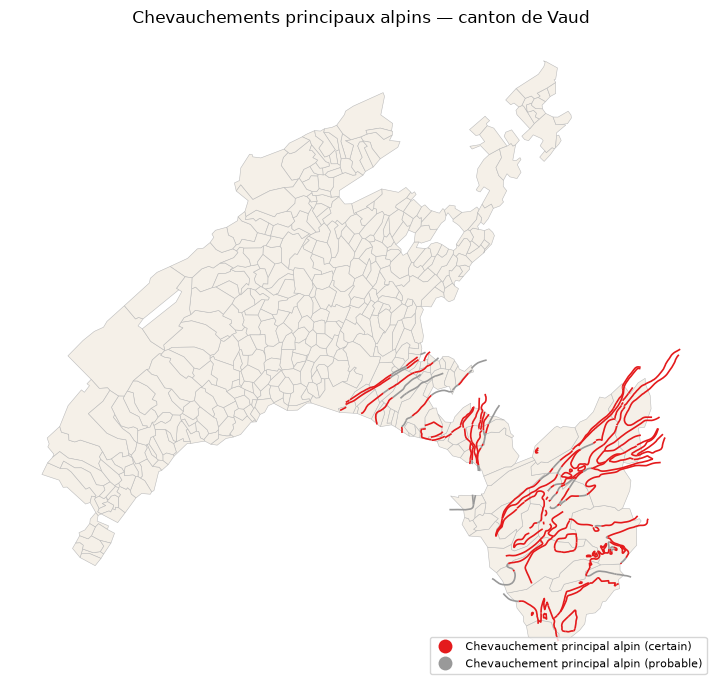
Filtrage attributaire (cf Section 2) — ne garder que les chevauchements principaux alpins
Filtrage spatial — parmi ceux-ci, ne conserver que ceux qui intersectent le territoire vaudois (couche
Communes)
# --- 3. Requête spatiale : chevauchements alpins dans Vaud ---

# Étape 1 : sélection attributaire
types_chev = [
    'Chevauchement principal alpin (certain)',
    'Chevauchement principal alpin (probable)'
]
chev = accidents[accidents['Type'].isin(types_chev)].copy()
print(f"Chevauchements alpins (total dataset)  : {len(chev)}")
print(chev['Type'].value_counts().to_string())

# Étape 2 : sélection spatiale
# gpd.sjoin(predicate='intersects') → garde les lignes qui croisent un polygone communal
chev_vaud = gpd.sjoin(
    chev,
    communes[['geometry']],
    how='inner',
    predicate='intersects'
)
chev_vaud = chev_vaud[~chev_vaud.index.duplicated()]   # supprimer les doublons
print(f"\nChevauchements dans Vaud               : {len(chev_vaud)}")

# Visualisation
fig, ax = plt.subplots(figsize=(10, 7))
communes.plot(ax=ax, color='#f5f0e8', edgecolor='#bbb', linewidth=0.4)
chev_vaud.plot(ax=ax, column='Type', cmap='Set1', linewidth=1.2,
               legend=True, legend_kwds={'loc': 'lower right', 'fontsize': 8})
ax.set_title('Chevauchements principaux alpins — canton de Vaud', fontsize=12)
ax.set_axis_off()
plt.tight_layout()
plt.show()
Chevauchements alpins (total dataset) : 6965
Type
Chevauchement principal alpin (certain) 5069
Chevauchement principal alpin (probable) 1896
Chevauchements dans Vaud : 235
4. Jointures¶
Les jointures permettent de combiner deux tables sur la base d’un attribut commun (jointure attributaire) ou d’une relation géométrique (jointure spatiale).
4.1 Jointure attributaire¶
Une jointure attributaire peut être réalisée en utilisant l’expression df1.merge(df2, left_on=col_df1, right_on=col_df2).
🗺️ Parallèle QGIS : Jointures dans les propriétés de la couche.
Dans l’exemple ci-dessous, on veut répondre à la question : Quelles sont les communes où il y a le plus de voitures ? Pour y répondre, on joint la table VoituresPlus (véhicules / 1 000 hab.) à la couche Communes via leurs colonnes respectives NAME et Communes.
voitures.head()communes.head()# --- 4.1 Jointure attributaire ---
communes_voit = communes.merge(
voitures[['Communes', 'Voitures_de_tourisme', 'Voitures_de_tourisme__1000_hab']],
left_on='NAME',
right_on='Communes',
how='left'
)
print(f"Résultat : {communes_voit.shape}")
print(f"Communes sans données : "
f"{communes_voit['Voitures_de_tourisme__1000_hab'].isna().sum()} / {len(communes_voit)}")
print()
top10 = (communes_voit.dropna(subset=['Voitures_de_tourisme__1000_hab'])
.sort_values('Voitures_de_tourisme__1000_hab', ascending=False)
.head(10))
print("Top 10 communes — véhicules / 1 000 hab. :")
print(top10[['NAME', 'Voitures_de_tourisme', 'Voitures_de_tourisme__1000_hab']]
.to_string(index=False))Résultat : (382, 11)
Communes sans données : 82 / 382
Top 10 communes — véhicules / 1 000 hab. :
NAME Voitures_de_tourisme Voitures_de_tourisme__1000_hab
Bursinel 509.0 1043.032787
Villars-Sainte-Croix 620.0 925.373134
Aclens 435.0 921.610169
Chavannes-de-Bogis 835.0 877.100840
Signy-Avenex 372.0 865.116279
Mies 1410.0 852.994555
Cuarny 144.0 842.105263
Bremblens 398.0 830.897704
Bougy-Villars 366.0 824.324324
Echandens 1756.0 801.460520
4.2 Jointure spatiale¶
Une jointure spatiale peut être réalisée en utilisant l’expression gpd.sjoin(gdf1, gdf2, predicate='intersects').
🗺️ Parallèle QGIS : Join Attributes by Location (outil de géotraitement).
Dans l’exemple ci-dessous, on veut savoir dans quelle commune se trouve chaque bâtiment du campus UNIL.
Utiliser gpd.sjoin() permet de comparer les géométries des deux couches et associe les attributs de la commune au bâtiment qui s’y trouve.
# --- 4.2 Jointure spatiale : bâtiments UNIL → commune ---
# predicate='intersects' pour capturer aussi les bâtiments sur les limites
bat_communes = gpd.sjoin(
    batiments,
    communes[['NAME', 'BEZIRK', 'geometry']],
    how='left',
    predicate='intersects'
)
# Un bâtiment peut intersecter plusieurs communes : garder la première occurrence
bat_communes = bat_communes[~bat_communes.index.duplicated(keep='first')]

print(f"Résultat : {bat_communes.shape}")
print()
print("Commune de chaque bâtiment UNIL :")
print(bat_communes[['name', 'amenity', 'NAME', 'BEZIRK']]
      .sort_values('NAME').to_string(index=False))
Résultat : (24, 9)
Commune de chaque bâtiment UNIL :
name amenity NAME BEZIRK
Château de Dorigny university Chavannes-près-Renens 2209
Bibliothèque Edouard Fleuret university Chavannes-près-Renens 2209
Archives Cantonales university Chavannes-près-Renens 2209
Ferme de la Mouline university Chavannes-près-Renens 2209
Geopolis university Chavannes-près-Renens 2209
Grange de Dorigny university Chavannes-près-Renens 2209
Bergerie university Chavannes-près-Renens 2209
Ferme de Dorigny university Chavannes-près-Renens 2209
Internef university Chavannes-près-Renens 2209
Anthropole university Chavannes-près-Renens 2209
Unicentre university Ecublens (VD) 2209
Serres university Ecublens (VD) 2209
Amphipole university Ecublens (VD) 2209
Institut Suisse de Droit Comparé university Ecublens (VD) 2209
Amphimax university Ecublens (VD) 2209
Unithèque library Ecublens (VD) 2209
Biophore university Ecublens (VD) 2209
Genopode university Ecublens (VD) 2209
Batochime university Ecublens (VD) 2209
La Maison Rose university Ecublens (VD) 2209
Villa des Sports university Saint-Sulpice (VD) 2209
Vestiaires university Saint-Sulpice (VD) 2209
Centre Nautique university Saint-Sulpice (VD) 2209
Chapelle Sainte-Claire place_of_worship Saint-Sulpice (VD) 2209
4.3 Relations plusieurs-à-plusieurs (N-N)¶
🗺️ Parallèle QGIS : Relations dans les propriétés du projet QGIS.
Une relation N-N permet d’associer plusieurs attributs d’une entité à plusieurs attributs d’une autre entité. Par exemple, elle permet d’associer plusieurs propriétaires à une même parcelle (et vice-versa), via une table intermédiaire :
Parcelles ──(NO_IMM)──► Proprietaire_Parcelle ──(NO_PROPRI)──► ProprietairesEn Python, on enchaîne deux merge().
# --- 4.3 Relations N-N : Parcelles ↔ Propriétaires ---
# Jointure en chaîne : Parcelles → Proprietaire_Parcelle → Proprietaires
parcelles_propri = (
    parcelles[['NO_IMM', 'NO_COMMUNE', 'SURFACE_RF', 'geometry']]
    .merge(prop_parc[['NO_IMM', 'NO_PROPRI']], on='NO_IMM', how='left')
    .merge(proprietaires[['NO_PROPRI', 'NOM_PROPRI']], on='NO_PROPRI', how='left')
)

print(f"Résultat : {parcelles_propri.shape}")
print(f"(une ligne par couple parcelle–propriétaire)")
print()

# Parcelles avec plusieurs propriétaires
multi_propri = (parcelles_propri.groupby('NO_IMM')
                .filter(lambda x: len(x) > 1)
                .sort_values('NO_IMM'))
print("Parcelles avec plusieurs propriétaires :")
print(multi_propri[['NO_IMM', 'SURFACE_RF', 'NO_PROPRI', 'NOM_PROPRI']]
      .to_string(index=False))
Résultat : (172, 6)
(une ligne par couple parcelle–propriétaire)
Parcelles avec plusieurs propriétaires :
NO_IMM SURFACE_RF NO_PROPRI NOM_PROPRI
1228 994.0 1 Aristote
1228 994.0 3 Descartes
1228 994.0 5 Thalès
1228 994.0 7 Pythagore
414 1700.0 7 Pythagore
414 1700.0 1 Aristote
437 761.0 6 Euclide
437 761.0 1 Aristote
457 608.0 7 Pythagore
457 608.0 3 Descartes
457 608.0 2 Ptolémée
468 1787.0 9 Ératosthène
468 1787.0 8 Pascal
537 960.0 4 Platon
537 960.0 9 Ératosthène
537 960.0 8 Pascal
559 657.0 7 Pythagore
559 657.0 2 Ptolémée
559 657.0 6 Euclide
559 657.0 1 Aristote
577 427.0 9 Ératosthène
577 427.0 5 Thalès
577 427.0 4 Platon
577 427.0 1 Aristote
577 427.0 6 Euclide
577 427.0 5 Thalès
585 480.0 2 Ptolémée
585 480.0 3 Descartes
652 10228.0 1 Aristote
652 10228.0 5 Thalès
652 10228.0 7 Pythagore
DP 1 541.0 10 Domaine public
DP 1 541.0 10 Domaine public
DP 1 1530.0 10 Domaine public
DP 1 1530.0 10 Domaine public
DP 1 2418.0 10 Domaine public
DP 1 2418.0 10 Domaine public
DP 2 1354.0 10 Domaine public
DP 2 999.0 10 Domaine public
DP 2 999.0 10 Domaine public
DP 2 1354.0 10 Domaine public
5. Cartographie choroplèthe¶
Une carte choroplèthe colore les polygones en fonction d’un attribut numérique. On visualise la densité de voitures par commune, issue de la jointure attributaire réalisée à la section 4.1.
5.1 Carte simple¶
# --- 5.1 Choroplèthe : véhicules / 1 000 hab. par commune ---
fig, ax = plt.subplots(figsize=(12, 9))

communes_voit.plot(
    ax=ax,
    column='Voitures_de_tourisme__1000_hab',
    cmap='YlOrRd',
    scheme='quantiles',
    k=5,
    legend=True,
    legend_kwds={'title': 'Véhicules/1 000 hab.', 'loc': 'lower left'},
    edgecolor='white',
    linewidth=0.3,
    missing_kwds={'color': 'lightgrey', 'label': 'Données manquantes'}
)

ax.set_title('Voitures de tourisme pour 1 000 habitants\nCommunes vaudoises (2010)',
             fontsize=13, pad=10)
ax.set_axis_off()
plt.tight_layout()
plt.show()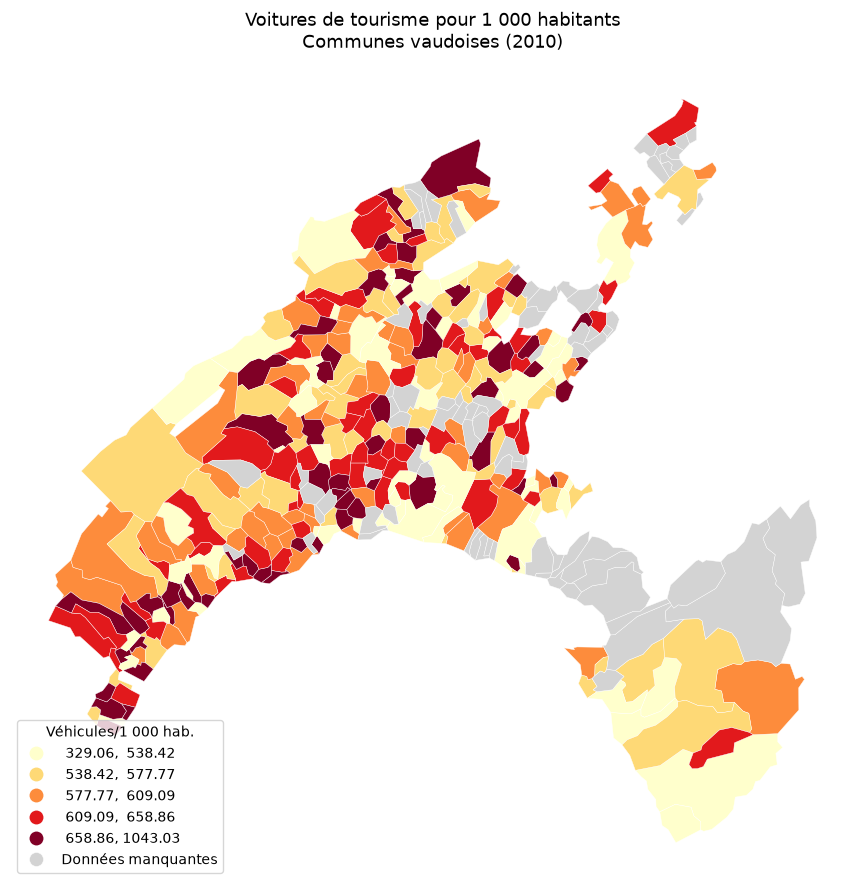
5.2 Méthodes de discrétisation¶
Le choix de la méthode de discrétisation (classification) influence fortement la lecture de la carte.
Méthode (scheme=) | Description |
|---|---|
'quantiles' | Classes contenant le même nombre d’entités |
'equal_interval' | Classes de même amplitude (intervalle de valeurs) |
'natural_breaks' (Jenks) | Minimise la variance intra-classe |
# --- 5.2 Comparaison des méthodes de discrétisation ---
methodes = ['quantiles', 'equal_interval', 'natural_breaks']
titres   = ['Quantiles (5 classes)', 'Intervalles égaux (5 classes)', 'Jenks (5 classes)']

fig, axes = plt.subplots(1, 3, figsize=(18, 6))

for ax, methode, titre in zip(axes, methodes, titres):
    communes_voit.plot(
        ax=ax,
        column='Voitures_de_tourisme__1000_hab',
        cmap='YlOrRd', scheme=methode, k=5,
        legend=True, legend_kwds={'fontsize': 7},
        edgecolor='white', linewidth=0.3,
        missing_kwds={'color': 'lightgrey'}
    )
    ax.set_title(titre, fontsize=10)
    ax.set_axis_off()

plt.suptitle("Véhicules / 1 000 hab. — méthodes de discrétisation", fontsize=13, y=1.01)
plt.tight_layout()
plt.show()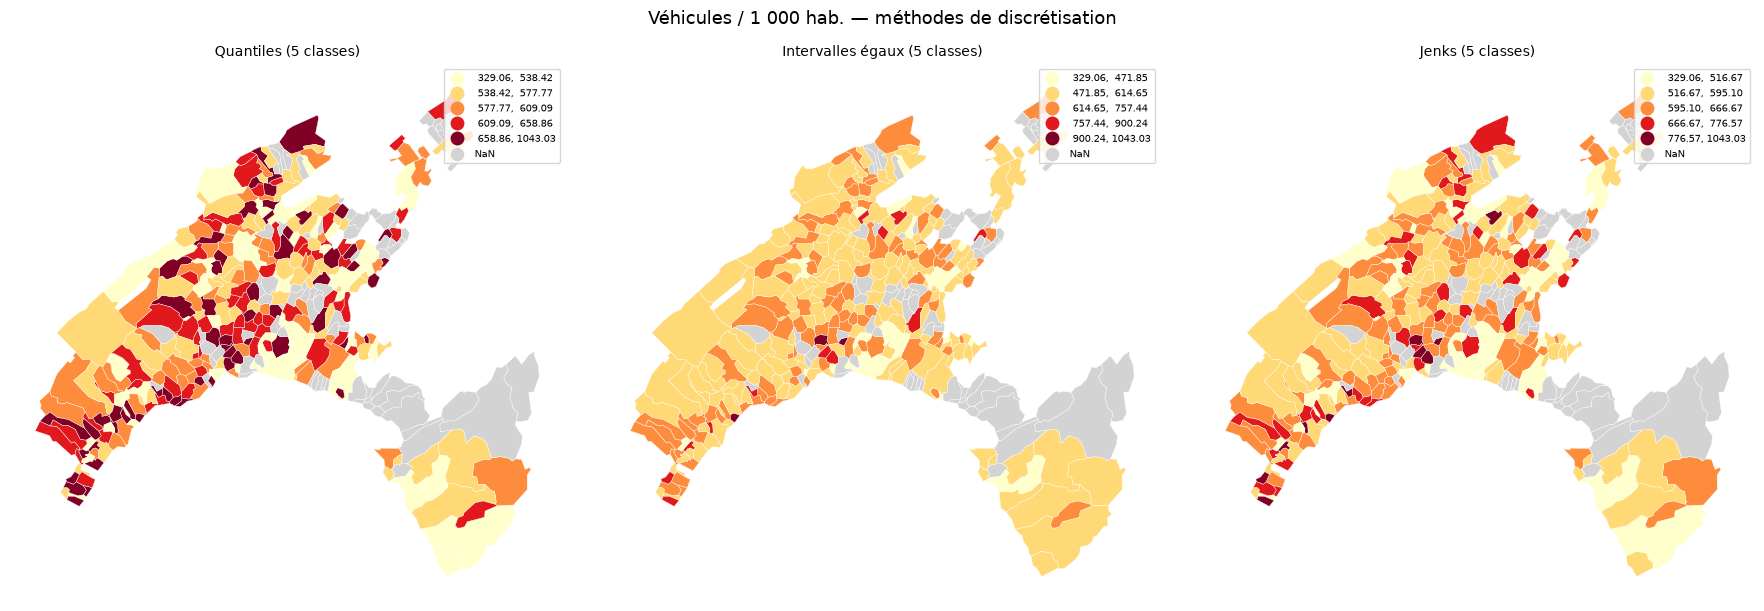
# --- Carte choroplèthe complète avec éléments cartographiques ---
fig, ax = plt.subplots(figsize=(12, 10))

communes_voit.plot(
    ax=ax,
    column='Voitures_de_tourisme__1000_hab',
    cmap='YlOrRd',
    scheme='natural_breaks', k=5,
    legend=True,
    legend_kwds={
        'title': 'Véhicules\n/1 000 hab.',
        'loc': 'lower right',
        'fontsize': 9,
        'title_fontsize': 10,
    },
    edgecolor='white', linewidth=0.3,
    missing_kwds={'color': '#cccccc', 'label': 'Données manquantes'}
)

ax.set_title("Voitures de tourisme pour 1 000 habitants\nCommunes vaudoises — 2010",
             fontsize=13, pad=12)
ax.set_axis_off()
ax.annotate('Source : OFS / tp2.gpkg', xy=(0.01, 0.01), xycoords='axes fraction',
            fontsize=8, color='grey')
plt.tight_layout()
plt.show()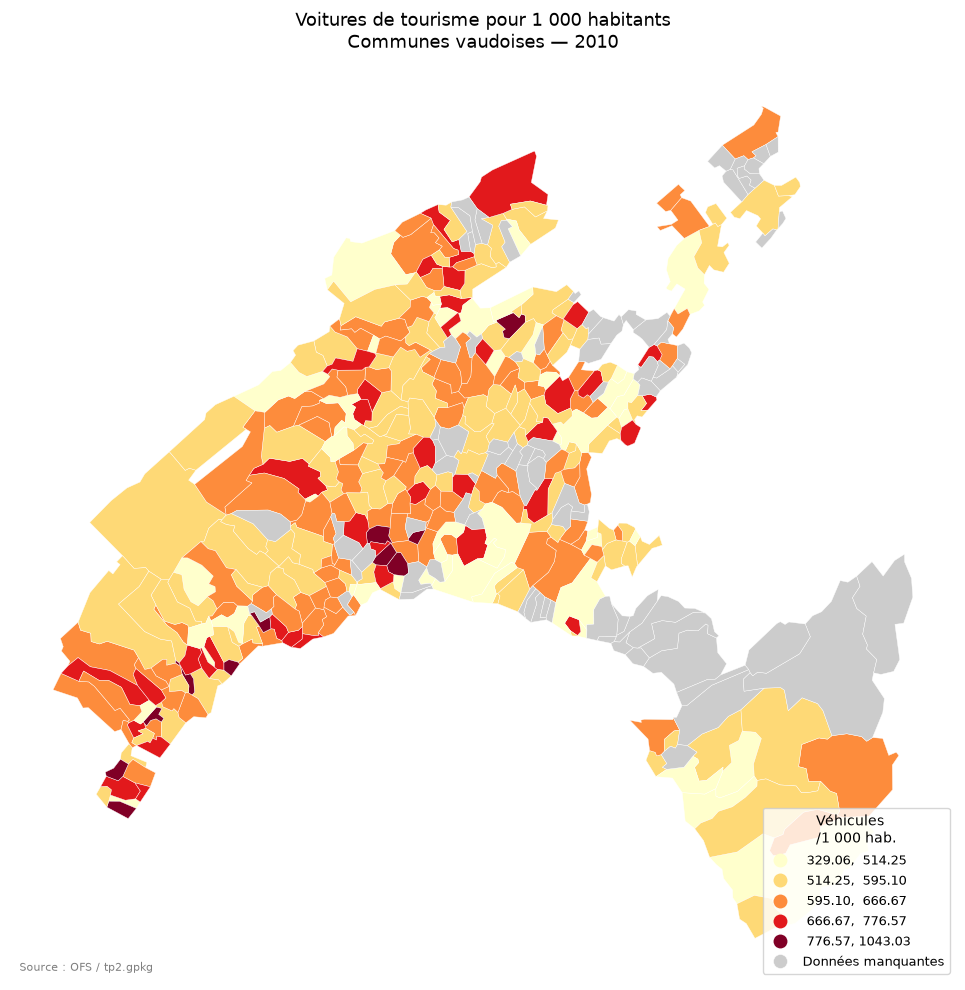
6. Régression linéaire et validation¶
Jusqu’ici, ce TP s’est concentré sur les géotraitements vectoriels. Cette dernière partie ouvre un fil conducteur qui se poursuit au TP03 et au TP04 : construire un modèle prédictif qui permette d’extrapoler à partir des observations. Pour ce faire, posons trois questions qui nous serviront de boussole au cours des prochains TPs et qu’il est nécessaire d’avoir en tête au début d’un projet de recherche en modélisation :
Quel modèle choisir ?
Comment le valider ?
Comment quantifier son incertitude ?
Dans ce premier exercice, on combine des données attributaires (résultats de votation) et les géométries des communes suisses pour répondre à une question prédictive concrète :
Peut-on prédire le résultat de l’Initiative 10 millions (2026) à partir du vote pour la Loi Climat (2023) ?
| Votation | Date | Description courte | Résultat national |
|---|---|---|---|
| Loi Climat (LCI) | juin 2023 | Loi sur la protection du climat et l’innovation énergétique | acceptée (59 %) |
| Initiative 10 millions | juin 2026 | Initiative pour la durabilité démographique | rejetée (39 %) |
Ces deux votations mobilisent des clivages politiques similaires (économie vs écologie, urbain vs rural). On s’attend donc à une corrélation forte à l’échelle communale — qu’on va quantifier, modéliser et valider.
6.1 Chargement et préparation des données¶
import pandas as pd
import numpy as np
from scipy import stats
import statsmodels.formula.api as smf
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import r2_score, mean_absolute_error

# --- Chargement des résultats de votation (tables du GeoPackage tp2.gpkg) ---
con = sqlite3.connect(DATA_PATH)
v23_raw = pd.read_sql('SELECT * FROM votation_2023', con)
v26_raw = pd.read_sql('SELECT * FROM votation_2026', con)
con.close()

# Dans un GeoPackage, les colonnes numériques peuvent être stockées en texte :
# on les convertit explicitement avant de filtrer et de calculer des pourcentages.
for d in (v23_raw, v26_raw):
    for col in ['proposal_id', 'yes_votes_count', 'cast_votes_count']:
        d[col] = pd.to_numeric(d[col], errors='coerce')

# Niveau communal uniquement, filtre par identifiant de scrutin
lci = v23_raw[(v23_raw['region_type'] == 'municipality') &
              (v23_raw['proposal_id'] == 6630)].copy()   # Loi Climat
m10 = v26_raw[(v26_raw['region_type'] == 'municipality') &
              (v26_raw['proposal_id'] == 6860)].copy()   # Initiative 10M

lci['oui_pct_lci'] = lci['yes_votes_count'] / lci['cast_votes_count'] * 100
m10['oui_pct_m10'] = m10['yes_votes_count'] / m10['cast_votes_count'] * 100

# Jointure interne sur l'identifiant communal : seules les communes présentes
# dans les deux scrutins sont conservées
df = (lci[['region_id', 'region_name', 'parent_canton_name', 'oui_pct_lci']]
      .merge(m10[['region_id', 'oui_pct_m10']], on='region_id')
      .dropna())

print(f"Communes retenues : {len(df)}")
print(f"  LCI — taux OUI : moy={df['oui_pct_lci'].mean():.1f}%  "
      f"[{df['oui_pct_lci'].min():.1f} – {df['oui_pct_lci'].max():.1f}%]")
print(f"  10M — taux OUI : moy={df['oui_pct_m10'].mean():.1f}%  "
      f"[{df['oui_pct_m10'].min():.1f} – {df['oui_pct_m10'].max():.1f}%]")
df.head()
Communes retenues : 2099
LCI — taux OUI : moy=50.6% [7.5 – 82.4%]
10M — taux OUI : moy=52.1% [16.3 – 90.4%]
6.2 Corrélation et visualisation¶
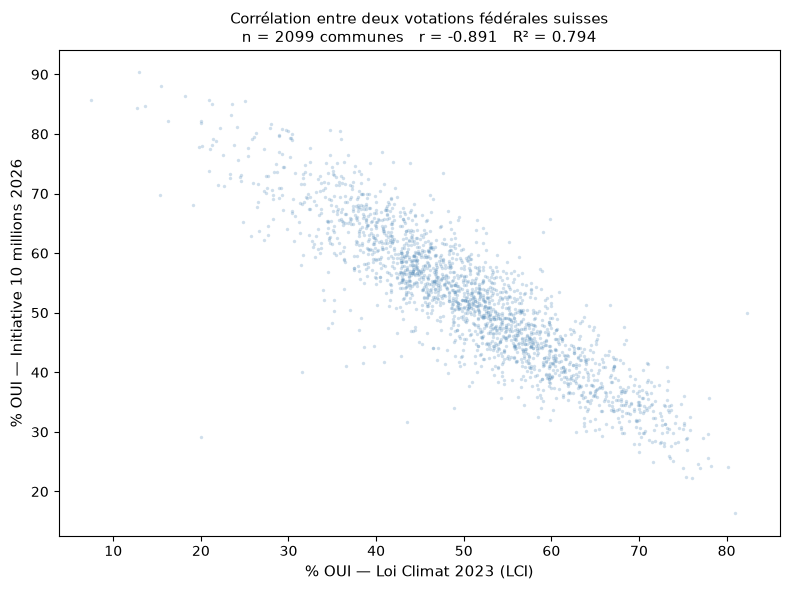
Avant de modéliser, on quantifie le lien linéaire entre les deux variables avec le coefficient de Pearson
qui varie de −1 (corrélation négative parfaite) à +1 (corrélation positive parfaite), 0 indiquant l’absence de lien linéaire.
Le coefficient de détermination mesure la proportion de variance de expliquée par le modèle :
où représente la valeur observée, la valeur prédite par le modèle, et la moyenne de toutes les valeurs observées de . est la somme des carrés des résidus (l’erreur du modèle) et la variance totale de autour de sa moyenne. signifie un ajustement parfait ; signifie que le modèle ne fait pas mieux que prédire systématiquement la moyenne . Pour une régression linéaire simple à un seul prédicteur, . Pour un modèle à plusieurs prédicteurs (TP03), reste défini par cette formule générale, même si n’a plus de sens univarié.
Une corrélation négative est attendue ici : les communes qui ont massivement voté OUI à la Loi Climat (sensibilité environnementale élevée) ont tendance à rejeter l’Initiative 10 millions (perçue comme anti-immigration ou anti-croissance), et vice-versa.
r, p_val = stats.pearsonr(df['oui_pct_lci'], df['oui_pct_m10'])
print(f"r = {r:.3f}   p-value = {p_val:.2e}")
print(f"→ Corrélation {'forte' if abs(r)>0.7 else 'modérée'} et "
      f"{'négative' if r < 0 else 'positive'} (R² = {r**2:.3f})")

fig, ax = plt.subplots(figsize=(8, 6))
ax.scatter(df['oui_pct_lci'], df['oui_pct_m10'],
           alpha=0.25, s=6, color='steelblue', linewidths=0)
ax.set_xlabel('% OUI — Loi Climat 2023 (LCI)', fontsize=11)
ax.set_ylabel('% OUI — Initiative 10 millions 2026', fontsize=11)
ax.set_title(f'Corrélation entre deux votations fédérales suisses\n'
             f'n = {len(df)} communes   r = {r:.3f}   R² = {r**2:.3f}', fontsize=11)
plt.tight_layout()
plt.show()
r = -0.891 p-value = 0.00e+00
→ Corrélation forte et négative (R² = 0.794)
6.3 Régression OLS — intervalles de confiance et de prédiction¶
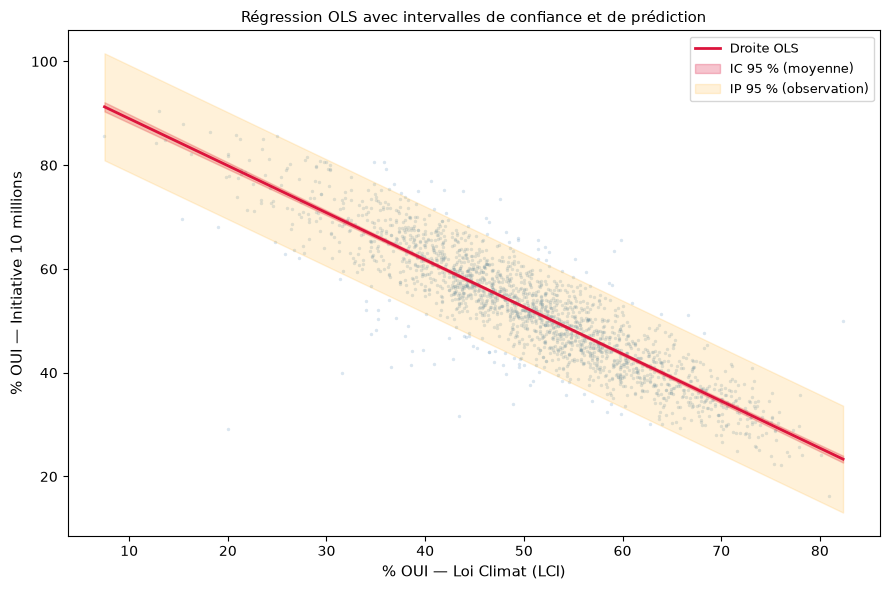
La régression OLS (Ordinary Least Squares) ajuste une droite qui minimise la somme des carrés des résidus.
statsmodels fournit deux types d’intervalles autour de cette droite :
| Intervalle | Signification | Largeur |
|---|---|---|
| Intervalle de confiance (IC) | Incertitude sur la moyenne de pour une valeur de donnée | Étroit |
| Intervalle de prédiction (IP) | Incertitude sur une observation individuelle pour la même valeur de | Large (inclut la variance résiduelle) |
En pratique : l’IC s’applique pour estimer la tendance centrale, l’IP pour prédire une commune spécifique.
# Ajustement OLS avec statsmodels (formule R-like)
model_ols = smf.ols('oui_pct_m10 ~ oui_pct_lci', data=df).fit()
print(model_ols.summary().tables[1])   # tableau des coefficients seulement
print(f"\nR² = {model_ols.rsquared:.3f}")

# Prédictions sur une grille régulière pour tracer IC et IP
x_grid = pd.DataFrame({'oui_pct_lci': np.linspace(df['oui_pct_lci'].min(),
                                                    df['oui_pct_lci'].max(), 300)})
pred = model_ols.get_prediction(x_grid).summary_frame(alpha=0.05)
# Colonnes : mean, mean_ci_lower, mean_ci_upper, obs_ci_lower, obs_ci_upper

fig, ax = plt.subplots(figsize=(9, 6))
ax.scatter(df['oui_pct_lci'], df['oui_pct_m10'],
           alpha=0.2, s=6, color='steelblue', linewidths=0, zorder=1)
ax.plot(x_grid['oui_pct_lci'], pred['mean'],
        color='crimson', linewidth=2, label='Droite OLS', zorder=3)
ax.fill_between(x_grid['oui_pct_lci'], pred['mean_ci_lower'], pred['mean_ci_upper'],
                color='crimson', alpha=0.25, label='IC 95 % (moyenne)', zorder=2)
ax.fill_between(x_grid['oui_pct_lci'], pred['obs_ci_lower'], pred['obs_ci_upper'],
                color='orange', alpha=0.15, label='IP 95 % (observation)', zorder=2)
ax.set_xlabel('% OUI — Loi Climat (LCI)', fontsize=11)
ax.set_ylabel('% OUI — Initiative 10 millions', fontsize=11)
ax.set_title('Régression OLS avec intervalles de confiance et de prédiction', fontsize=11)
ax.legend(fontsize=9)
plt.tight_layout()
plt.show()
===============================================================================
coef std err t P>|t| [0.025 0.975]
-------------------------------------------------------------------------------
Intercept 98.0527 0.524 187.212 0.000 97.026 99.080
oui_pct_lci -0.9072 0.010 -89.831 0.000 -0.927 -0.887
===============================================================================
R² = 0.794
6.4 Surapprentissage (overfitting)¶
Un modèle avec trop de paramètres libres par rapport au nombre d’observations peut coller presque parfaitement aux données d’entraînement — bruit compris. Il mémorise l’échantillon au lieu d’apprendre la tendance réelle, et généralise mal à de nouvelles données : c’est le surapprentissage (overfitting).
Pour le voir concrètement, on compare une droite (peu flexible, 2 paramètres) à un polynôme de degré 6 (très flexible, 7 paramètres), tous deux ajustés sur un petit échantillon de 15 communes. Avec aussi peu de points, un modèle flexible a la place d’onduler entre chaque observation plutôt que de suivre la tendance générale.
On évalue ensuite les deux modèles sur les communes restantes, jamais vues lors de l’ajustement.
rng = np.random.default_rng(0)
sample_idx = rng.choice(len(df), size=15, replace=False)
rest_idx   = np.setdiff1d(np.arange(len(df)), sample_idx)

x_s, y_s = df['oui_pct_lci'].values[sample_idx], df['oui_pct_m10'].values[sample_idx]
x_r, y_r = df['oui_pct_lci'].values[rest_idx],   df['oui_pct_m10'].values[rest_idx]

degrees = [1, 6]
x_line = np.linspace(df['oui_pct_lci'].min(), df['oui_pct_lci'].max(), 300)

fig, ax = plt.subplots(figsize=(9, 6))
ax.scatter(x_r, y_r, alpha=0.08, s=6, color='grey', label='Reste des communes (jamais vues)')
ax.scatter(x_s, y_s, s=40, color='black', zorder=5, label="Échantillon d'entraînement (n=15)")

results = []
for deg, color in zip(degrees, ['crimson', 'orange']):
    coeffs = np.polyfit(x_s, y_s, deg)
    ax.plot(x_line, np.polyval(coeffs, x_line), color=color, linewidth=2, label=f'Degré {deg}')

    r2_train   = r2_score(y_s, np.polyval(coeffs, x_s))
    r2_heldout = r2_score(y_r, np.polyval(coeffs, x_r))
    results.append((deg, r2_train, r2_heldout))

ax.set_ylim(y_r.min() - 10, y_r.max() + 10)   # les oscillations du degré 6 sortent vite du cadre
ax.set_xlabel('% OUI — LCI'); ax.set_ylabel('% OUI — 10M')
ax.legend(fontsize=9)
ax.set_title('Surapprentissage : droite vs polynôme de degré 6 (ajustés sur n=15)')
plt.tight_layout()
plt.show()

print(f"{'Degré':<8}{'R² (entraînement, n=15)':<26}{'R² (reste, jamais vu)':<24}")
for deg, r2_tr, r2_ho in results:
    print(f"{deg:<8}{r2_tr:<26.3f}{r2_ho:<24.3f}")
print("\nLe polynôme de degré 6 explique mieux les 15 points d'entraînement que la droite,")
print("mais généralise beaucoup plus mal (R² très négatif, bien pire que de prédire la")
print("moyenne) : il a appris le bruit de cet échantillon précis, pas la tendance réelle.")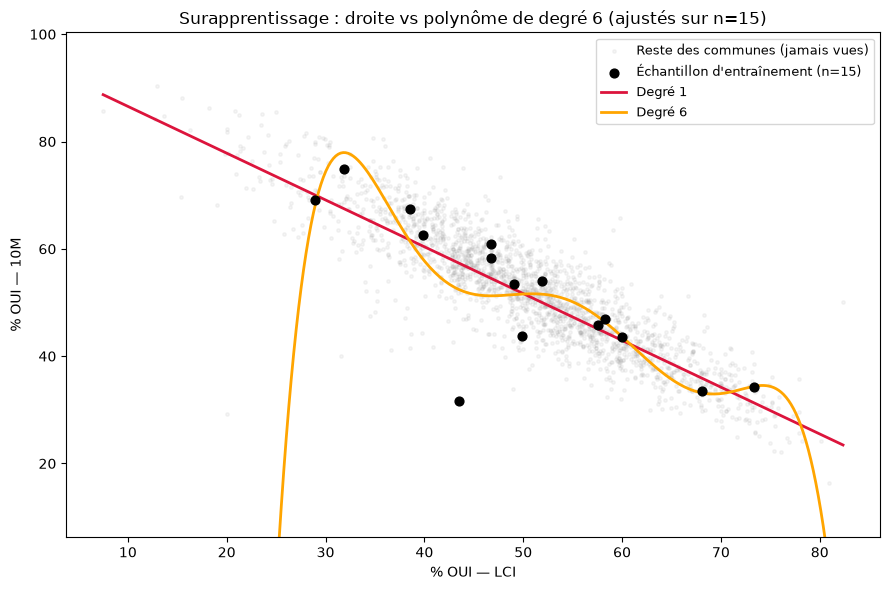
Degré   R² (entraînement, n=15)   R² (reste, jamais vu)
1       0.643                     0.786
6       0.719                     -114.627

Le polynôme de degré 6 explique mieux les 15 points d'entraînement que la droite,
mais généralise beaucoup plus mal (R² très négatif, bien pire que de prédire la
moyenne) : il a appris le bruit de cet échantillon précis, pas la tendance réelle.
6.5 Validation — séparation entraînement / test¶
La démonstration précédente (§6.4) montre le symptôme du surapprentissage dans un cas extrême. En pratique, on ne compare pas visuellement des courbes : on mesure la capacité de généralisation avec un protocole systématique, applicable à n’importe quel modèle — même un modèle aussi simple qu’une droite OLS.
Les métriques calculées sur l’ensemble complet (model_ols.rsquared) restent optimistes, pour la même raison que ci-dessus : le modèle a été ajusté sur exactement ces données, donc il les « connaît » déjà. Pour estimer la capacité prédictive réelle (généralisation), on évalue le modèle sur des données qu’il n’a jamais vues :
On divise aléatoirement en entraînement (80 %) et test (20 %).
On ajuste le modèle uniquement sur l’entraînement.
On évalue sur le test.
La §6.6 revient en détail sur les métriques utilisées pour évaluer ce modèle, et sur la question — trop souvent négligée — de savoir si le résultat obtenu est réellement bon.
X = df[['oui_pct_lci']].values
y = df['oui_pct_m10'].values

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42)

model_val = LinearRegression().fit(X_train, y_train)
y_pred_test = model_val.predict(X_test)

r2 = r2_score(y_test, y_pred_test)
print(f"Entraînement : {len(X_train)} communes   Test : {len(X_test)} communes")
print(f"R² (test) = {r2:.3f}")
Entraînement : 1679 communes Test : 420 communes
R² (test) = 0.763
6.6 Métriques d’évaluation et benchmarking¶
Le R² calculé en §6.5 résume la performance en un seul chiffre, mais un projet de modélisation a généralement besoin d’un ensemble de métriques adaptées à différents usages, et surtout d’un point de comparaison pour savoir si ce chiffre est bon.
Trois métriques, trois usages différents :
| Métrique | Formule | Unité | Usage |
|---|---|---|---|
| R² | sans unité, ∈ ]−∞, 1] | Comparer des modèles entre eux, même sur des variables cibles différentes | |
| MAE (Mean Absolute Error) | même unité que (points de %) | Erreur « typique », facile à expliquer à un public non technique | |
| RMSE (Root Mean Square Error) | même unité que (points de %) | Comme MAE, mais pénalise davantage les grosses erreurs (utile si une grosse erreur coûte disproportionnellement plus cher) |
RMSE ≥ MAE toujours (égalité seulement si toutes les erreurs ont la même amplitude) : un grand écart entre les deux signale quelques erreurs très importantes plutôt qu’une erreur uniformément répartie.
Le benchmarking : un chiffre seul ne veut rien dire. Un MAE de quelques points de % est-il bon ? Impossible à dire sans point de comparaison. Le plus simple est un modèle naïf (benchmark) qui ignore le prédicteur et prédit toujours la moyenne d’entraînement — c’est exactement la situation (§6.2). Un modèle qui ne fait pas mieux que ce benchmark n’apporte aucune information utile, quel que soit son R² en apparence raisonnable sur le papier. On calcule ci-dessous les trois métriques pour ce benchmark et pour le modèle OLS (§6.5), sur le même jeu de test, pour une comparaison directe.
💡 Bonne pratique : dans un projet réel, définis ton benchmark avant de regarder les résultats de ton modèle. Choisir un point de comparaison après coup risque de le sélectionner, consciemment ou non, pour flatter le modèle qu’on a déjà.
mae  = mean_absolute_error(y_test, y_pred_test)
rmse = np.sqrt(np.mean((y_test - y_pred_test) ** 2))

# --- Benchmark : modèle naïf qui prédit toujours la moyenne d'entraînement ---
y_pred_baseline = np.full_like(y_test, y_train.mean())
r2_base   = r2_score(y_test, y_pred_baseline)
mae_base  = mean_absolute_error(y_test, y_pred_baseline)
rmse_base = np.sqrt(np.mean((y_test - y_pred_baseline) ** 2))

print(f"{'Métrique':<10}{'Benchmark (moyenne)':<22}{'Modèle OLS':<12}")
print(f"{'R²':<10}{r2_base:<22.3f}{r2:<12.3f}")
print(f"{'MAE':<10}{mae_base:<22.2f}{mae:<12.2f}")
print(f"{'RMSE':<10}{rmse_base:<22.2f}{rmse:<12.2f}")
print()
print(f"Le benchmark a un R² ≈ 0 : sans surprise, « toujours prédire la moyenne » n'explique")
print(f"aucune variance (§6.2). Le modèle OLS réduit le MAE de "
      f"{100 * (1 - mae / mae_base):.0f} % par rapport à ce benchmark.")
print(f"Interprétation : en moyenne, l'erreur de prédiction du modèle est ±{mae:.1f} points de %,")
print(f"contre ±{mae_base:.1f} points de % pour le benchmark — le modèle apporte une information réelle,")
print(f"pas seulement un ajustement qui a l'air raisonnable sur le papier.")
Métrique Benchmark (moyenne) Modèle OLS
R² -0.003 0.763
MAE 9.10 3.86
RMSE 11.22 5.45
Le benchmark a un R² ≈ 0 : sans surprise, « toujours prédire la moyenne » n'explique
aucune variance (§7.2). Le modèle OLS réduit le MAE de 58 % par rapport à ce benchmark.
Interprétation : en moyenne, l'erreur de prédiction du modèle est ±3.9 points de %,
contre ±9.1 points de % pour le benchmark — le modèle apporte une information réelle,
pas seulement un ajustement qui a l'air raisonnable sur le papier.
6.7 Sélection géographique vs aléatoire¶
Le split aléatoire de la §6.5 disperse les communes test sur tout le territoire : chaque commune test a des voisines dans l’entraînement, ce qui aide implicitement le modèle. En pratique, on souhaite souvent prédire pour une région entière — un canton, une zone linguistique — à partir des autres. C’est un changement de contexte d’apprentissage : le modèle doit généraliser à une population différente de celle sur laquelle il a été entraîné, pas seulement à de nouvelles observations de la même population.
On compare, à effectif d’entraînement identique (même nombre de communes des deux côtés, pour une comparaison équitable — pas le split 80/20 de la §6.5, dont les proportions diffèrent) :
Split aléatoire : entraînement sur un tirage aléatoire de communes, test sur le reste, mélangés sur tout le territoire.
Split géographique : entraînement uniquement sur la Suisse alémanique, test sur la Romandie et le Tessin — une région entière, jamais vue à l’entraînement.
C’est une autre facette du surapprentissage (§6.4) : même un modèle aussi simple qu’une droite OLS peut « surapprendre » le contexte particulier de ses données d’entraînement (ici, une région du pays), sans que cela se voie dans un split aléatoire classique.
Comment lire la figure ci-dessous. La rangée du haut montre la géographie de chaque séparation — quelles communes servent à l’entraînement (gris) et lesquelles au test (orange) : dispersées sur tout le pays à gauche, regroupées en un bloc contigu à droite. La rangée du bas montre les résidus correspondants sur le jeu de test. On surveille surtout le biais moyen annoté sous chaque carte : proche de zéro pour le split aléatoire (les erreurs se compensent d’une région à l’autre), mais nettement décalé pour le split géographique — le modèle se trompe systématiquement sur une région entière qu’il n’a jamais vue, ce qu’un simple R² global masquerait.
# Géométries des communes suisses (couche Communes_CH de tp2.gpkg) pour cartographier les résidus.
# GEM_TEIL == '0' : polygone principal de chaque commune (pas les enclaves)
communes_ch = (gpd.read_file(DATA_PATH, layer='Communes_CH')
               .to_crs('EPSG:21781'))
communes_ch = communes_ch[
    communes_ch['KANTONSNUM'].str.startswith('CH', na=False) &
    (communes_ch['GEM_TEIL'] == '0')
]

# Régions linguistiques (simplifié — cantons officiellement francophones ou italophones)
romand = {'Vaud', 'Genève', 'Neuchâtel', 'Jura', 'Fribourg', 'Valais'}
tessin = {'Tessin'}
def region(canton):
    if canton in romand: return 'Romand'
    if canton in tessin: return 'Tessin'
    return 'Alémanique'

df['region_ling'] = df['parent_canton_name'].map(region)
print("Distribution linguistique :")
print(df['region_ling'].value_counts().to_string())

mask_al = (df['region_ling'] == 'Alémanique').values
n_tr, n_te = mask_al.sum(), (~mask_al).sum()

# --- Split géographique : entraînement = Alémanique, test = Romandie + Tessin ---
model_geo = LinearRegression().fit(X[mask_al], y[mask_al])
resid_geo_arr = y[~mask_al] - model_geo.predict(X[~mask_al])
r2_geo  = r2_score(y[~mask_al], model_geo.predict(X[~mask_al]))
mae_geo = mean_absolute_error(y[~mask_al], model_geo.predict(X[~mask_al]))

# --- Split aléatoire à effectif IDENTIQUE (n_tr entraînement / n_te test) ---
# Un modèle réajusté sur toutes les communes (comme model_ols en §6.3) aurait déjà "vu"
# les communes de test : ce ne serait pas une évaluation hors échantillon valable.
rng_split = np.random.default_rng(42)
perm = rng_split.permutation(len(df))
idx_tr_rand, idx_te_rand = perm[:n_tr], perm[n_tr:n_tr + n_te]

model_rand = LinearRegression().fit(X[idx_tr_rand], y[idx_tr_rand])
resid_rand_arr = y[idx_te_rand] - model_rand.predict(X[idx_te_rand])
r2_rand  = r2_score(y[idx_te_rand], model_rand.predict(X[idx_te_rand]))
mae_rand = mean_absolute_error(y[idx_te_rand], model_rand.predict(X[idx_te_rand]))

bias_rand, bias_geo = resid_rand_arr.mean(), resid_geo_arr.mean()

print()
print(f"Effectif (identique dans les deux cas) : {n_tr} entraînement / {n_te} test")
print(f"Split aléatoire     : R² = {r2_rand:.3f}   MAE = {mae_rand:.2f} pts%   biais = {bias_rand:+.2f} pts%")
print(f"Split géographique  : R² = {r2_geo:.3f}   MAE = {mae_geo:.2f} pts%   biais = {bias_geo:+.2f} pts%")
print("  (entraîné sur la Suisse alémanique → prédit Romandie + Tessin)")

# --- Rattacher chaque commune à sa géométrie, avec son rôle (entraînement / test) ---
geo = communes_ch[['NAME', 'geometry']]

role_rand = np.empty(len(df), dtype=object)
role_rand[idx_tr_rand] = 'train'
role_rand[idx_te_rand] = 'test'
df_split = df[['region_name']].copy()
df_split['role_rand'] = role_rand
df_split['role_geo']  = np.where(mask_al, 'train', 'test')

gdf_rand_all = geo.merge(df_split[['region_name', 'role_rand']],
                         left_on='NAME', right_on='region_name', how='inner')
gdf_geo_all  = geo.merge(df_split[['region_name', 'role_geo']],
                         left_on='NAME', right_on='region_name', how='inner')

# Résidus rattachés à la géométrie (jeu de test uniquement)
df_rand_te = df.iloc[idx_te_rand][['region_name']].copy()
df_rand_te['resid'] = resid_rand_arr
gdf_rand = geo.merge(df_rand_te, left_on='NAME', right_on='region_name', how='inner')

df_geo_te = df.loc[~mask_al, ['region_name']].copy()
df_geo_te['resid'] = resid_geo_arr
gdf_geo = geo.merge(df_geo_te, left_on='NAME', right_on='region_name', how='inner')

vabs = max(gdf_rand['resid'].abs().quantile(0.97), gdf_geo['resid'].abs().quantile(0.97))

# --- Figure 2×2 : en haut la stratégie de séparation, en bas les résidus ---
fig, axes = plt.subplots(2, 2, figsize=(13, 11))
C_TRAIN, C_TEST = '#cfd8dc', '#ef6c00'

# Rangée du haut : QUI est en entraînement (gris) vs en test (orange)
for ax, gdf_all, role_col, titre in [
    (axes[0, 0], gdf_rand_all, 'role_rand', f'Split aléatoire — test dispersé (n={n_te})'),
    (axes[0, 1], gdf_geo_all,  'role_geo',  f'Split géographique — test = Romandie + Tessin (n={n_te})'),
]:
    gdf_all[gdf_all[role_col] == 'train'].plot(ax=ax, color=C_TRAIN, edgecolor='white', linewidth=0.15)
    gdf_all[gdf_all[role_col] == 'test'].plot(ax=ax, color=C_TEST, edgecolor='white', linewidth=0.15)
    ax.set_title(titre, fontsize=10)
    ax.set_axis_off()
axes[0, 0].legend(handles=[mpatches.Patch(facecolor=C_TRAIN, label='Entraînement'),
                           mpatches.Patch(facecolor=C_TEST, label='Test')],
                  loc='lower left', fontsize=9, frameon=False)

# Rangée du bas : les résidus qui en résultent, même échelle de couleur des deux côtés
for ax, gdf_resid, r2v, maev, biasv, titre in [
    (axes[1, 0], gdf_rand, r2_rand, mae_rand, bias_rand, 'Résidus — split aléatoire'),
    (axes[1, 1], gdf_geo,  r2_geo,  mae_geo,  bias_geo,  'Résidus — split géographique'),
]:
    communes_ch.plot(ax=ax, color='#f0f0f0', edgecolor='white', linewidth=0.2)
    gdf_resid.plot(ax=ax, column='resid', cmap='PiYG', vmin=-vabs, vmax=vabs, legend=True,
                   legend_kwds={'shrink': 0.6, 'label': 'résidu (points %)'}, edgecolor='none')
    ax.set_title(f'{titre}\nR² = {r2v:.2f}   MAE = {maev:.2f}   biais = {biasv:+.2f} pts%', fontsize=10)
    ax.set_axis_off()

plt.suptitle("Global (aléatoire) vs localisé (géographique) : même effectif d'entraînement, résultats très différents",
             fontsize=13, y=0.99)
plt.tight_layout()
plt.show()
Récapitulatif¶
Parties 1–5 — Géotraitements vectoriels avec GeoPandas¶
| Opération QGIS | Code Python |
|---|---|
| Sélection par expression | gdf[gdf['col'] == val], .isin(), .query() |
| Sélection par localisation | gpd.sjoin(predicate='intersects') |
| Jointure attributaire | df.merge(other, left_on=..., right_on=...) |
| Relation N-N | double merge() via table intermédiaire |
| Carte choroplèthe | .plot(column=..., scheme=..., cmap=...) |
Partie 6 — Régression linéaire et validation¶
| Étape | Code clé |
|---|---|
| Corrélation de Pearson | scipy.stats.pearsonr(x, y) |
| OLS avec intervalles | smf.ols(...).fit() + .get_prediction().summary_frame() |
| Démonstration du surapprentissage | np.polyfit(x, y, deg=6) sur un petit échantillon |
| Split entraînement/test | train_test_split(X, y, test_size=0.2) |
| Métriques | r2_score, mean_absolute_error, RMSE via np.sqrt(np.mean((y_true - y_pred)**2)) |
| Benchmark | comparer aux métriques d’un modèle naïf (prédire la moyenne d’entraînement) |
| Split géographique | entraîner sur un sous-ensemble régional, évaluer sur le reste |
Points clés à retenir :
; pour une régression simple à un prédicteur, .
R² est sans unité (comparer des modèles) ; MAE et RMSE sont dans l’unité de (interpréter une erreur concrète) ; RMSE ≥ MAE toujours, l’écart entre les deux révèle des erreurs ponctuellement grandes.
🎯 Bonnes pratiques ML — niveau 1 : les fondamentaux¶
| Principe | Où on l’a vu |
|---|---|
| Ne jamais évaluer un modèle sur les données qui ont servi à l’entraîner, la performance mesurée est alors malhonnête. Quand une partie des données d’évaluation sont incluses dans l’entraînement, on parle alors de “data leakage” (fuite de données) et c’est un concept auquel il faut être particulièrement attentif lorsqu’on code en utilisant des chatbots. | §6.4 (surapprentissage), §6.5 (train/test) |
| Toujours comparer à un benchmark, un chiffre de performance seul ne veut rien dire, même s’il « a l’air raisonnable » | §6.6 |
| Choisir la métrique adaptée à la question : R² pour comparer des modèles, MAE/RMSE pour une erreur directement interprétable | §6.6 |
| Réfléchir à qui compose le jeu de test, pas seulement à sa taille : un split aléatoire peut cacher un échec de généralisation qu’un split structuré (ici, géographique) révèle | §6.7 |
Ces quatre principes sont les fondations de tout projet de modélisation, indépendamment du modèle utilisé.
📝 Quiz Moodle¶
Une fois ce TP terminé, teste tes connaissances avec le quiz Moodle du TP2 :
👉 Ouvrir le quiz du TP2 sur Moodle (accès réservé aux étudiant·e·s UNIL)